3. процедуры: информация, статистика, таблицы
Содержание:
Данные не существуют сами по себе: они появляются через системы различий, способы их сбора и хранения. Таблицы, классификации и визуализации не просто показывают данные, но и формируют представление о мире.
/ таблицы и рутины
Когда мы говорим про количественные данные, они часто выглядят как таблички. Это неспроста. Таблица — вовсе не единственная форма представления пусть даже сходных элементов. Могут быть списки, mindmaps, картинки. Таблица, в отличие от них, однозначно упорядочена и показывает первичные связи и структуру. Она позволяет легко автоматизировать многие процессы сбора данных, освобождая нас от рутинных действий.
Действительно, если данные находятся в таблице, их не нужно классифицировать самим. Значит, работа по классификации (часто довольно скучная) отводится машине, а человеку остаётся творчество. Вроде бы это и хорошо?
Не споря с этим, заметим, что, во-первых, это делит работу на творческую и не очень (и в этом смысле наследует логике производства алгоритмов — где машины выполняют ту работу, которую раньше делали люди на малооплачиваемой работе, да и сейчас иногда делают).
Во-вторых, таблица освобождает заодно и от рефлексии — что именно разместить сюда, а что — туда. На каждом следующем уровне, отдаляясь от таблицы, специалисты уже ничего не могут изменить: им остаётся иметь дело с готовым материалом. Например, про посетителей музея можно узнать только пол, возраст и город происхождения. Данные оказываются вроде бы «чистыми» — не связанными с контекстом их производства. Но эта «чистота» может быть следствием того, что мы не понимаем устройства процессов, которые стоят за табличкой.
Где могут быть несовпадения? Об этом, например, пишет Жаклин Вернимон в книге «Исчислимые жизни» — о количественных медиа, которые по-разному запечатлевали жизнь и смерть — это и таблицы смертности, и судовые декларации, и педометры, и селф-трекинг девайсы (Wernimont, J. 2019). Рецензию на книгу на русском языке можно прочитать здесь.
Действительно, если данные находятся в таблице, их не нужно классифицировать самим. Значит, работа по классификации (часто довольно скучная) отводится машине, а человеку остаётся творчество. Вроде бы это и хорошо?
Не споря с этим, заметим, что, во-первых, это делит работу на творческую и не очень (и в этом смысле наследует логике производства алгоритмов — где машины выполняют ту работу, которую раньше делали люди на малооплачиваемой работе, да и сейчас иногда делают).
Во-вторых, таблица освобождает заодно и от рефлексии — что именно разместить сюда, а что — туда. На каждом следующем уровне, отдаляясь от таблицы, специалисты уже ничего не могут изменить: им остаётся иметь дело с готовым материалом. Например, про посетителей музея можно узнать только пол, возраст и город происхождения. Данные оказываются вроде бы «чистыми» — не связанными с контекстом их производства. Но эта «чистота» может быть следствием того, что мы не понимаем устройства процессов, которые стоят за табличкой.
Где могут быть несовпадения? Об этом, например, пишет Жаклин Вернимон в книге «Исчислимые жизни» — о количественных медиа, которые по-разному запечатлевали жизнь и смерть — это и таблицы смертности, и судовые декларации, и педометры, и селф-трекинг девайсы (Wernimont, J. 2019). Рецензию на книгу на русском языке можно прочитать здесь.
Лондонским приходским клеркам было предоставлено исключительное право публиковать списки смертей, которые сами по себе представляли собой сильно сжатые документы, составленные на основе записей о смертях, хранящихся в приходских регистрах, и отчетов, собранных часто женщинами-сотрудницами. В то время как приходские регистры фиксировали важные события в жизни, предоставляя информацию о возрасте на момент смерти, причине смерти, крещениях и, иногда, контрактах, списки сводили эту информацию в таблицу смертей по категориям.
…
Печатая каждую неделю один и тот же упорядоченный формальный отчет, приходские клерки могли стереть любые признаки неопределенности или ошибки в подсчете умерших.
… отчеты создавали иронически идеализированный мир, в котором отчетность об эпидемических заболеваниях и массовой смертности казалась такой же чистой и упорядоченной, как бухгалтерская книга.
И, конечно, немало альтернатив есть в художнических проектах. Например, организация ART/DATA/HEALTH поддерживает именно такие проекты — те, что работают с данными, но не просто показывая их, а предъявляя их телесность. Например, проект Shielding о том, сколько женщин пострадали от домашнего насилия во время пандемии. Но это уже вопросы представления данных, а нам нужно ещё немного остановиться на теории, чтобы понять, что может быть «дано».
/ до начала производства
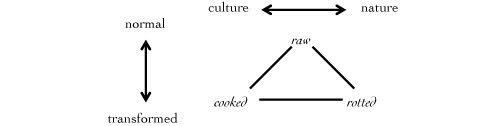
Схема Тома Бёлсторффа
Этот рисунок Том Бёлсторфф использует, чтобы уточнить, что сырых данных не бывает, чтобы объяснить это, он использует схему Леви-Стросса, обычно относимую к еде. Стрелочки слева и сверху — это оси координат. По ним данные (как и еда) могут быть ближе к природе или к культуре (хотя сама эта дихотомия природы/культуры очень спорная, оставим её тут в таком виде), а также скорее «нормальными» или обработанными, трансформированными. В итоге данные делятся на сырые, приготовленные и гнилые.
Сырых данных не может быть, так как они всегда предзаданы способом сбора. А гнилые данные — это те, с которыми что-то пошло не так (например, изменился источник сбора данных, а таблица осталась прежней).
Сырых данных не может быть, так как они всегда предзаданы способом сбора. А гнилые данные — это те, с которыми что-то пошло не так (например, изменился источник сбора данных, а таблица осталась прежней).
Подробнее об этом можно почитать в сборнике Raw data is an oxymoron.
/ классификация: разбираемся на примере из леса
Исследователи задают те параметры / действия / события / объекты, которые будут фиксироваться. Фиксируются вовсе не все явления мира, а те, которые мы умеем различать и каталогизировать. В разные времена и в разных культурах это отличается.
Например, человек из города, приходя в лес, в основном видит там только ряды деревьев и кустов. А лесник видит огромное количество разнообразных растений, животных, хвощей и папоротников. И понимает, например, где дупло — это просто дупло, а где — жилище белочки, и что увидеть маленьких полосатых кабанчиков — плохой знак. Если параметры для сбора данных по лесу задаст лесник, это будут одни параметры, если лесозаготовитель — другие, продвинутый грибник — третьи, а горожанин — четвёртые.
Следующий шаг — понять, как данные будут собираться, какими будут способы их регистрации, как они будут связаны с явлением и какая добродетель (virtue) будет лежать в их основе.
Про добродетель нужно пояснить. Это объяснение мы берём из замечательной книги «Объективность» Питера Галисона и Лорейн Дастон (Галлисон, Дастон, 2918).
Они описывают, как формировалась идея «объективного» отражения природы в научных атласах. Ещё до XIX века учёным было очень важно, чтобы в изображении объекта (животного, органа, растения) соблюдалось соответствие идеалу. Это значит, что шероховатые, асимметричные образцы просто не принимались в расчёт. Они были тем, что сегодня иногда оказывается «мусором» и в работе с данными.
Про добродетель нужно пояснить. Это объяснение мы берём из замечательной книги «Объективность» Питера Галисона и Лорейн Дастон (Галлисон, Дастон, 2918).
Они описывают, как формировалась идея «объективного» отражения природы в научных атласах. Ещё до XIX века учёным было очень важно, чтобы в изображении объекта (животного, органа, растения) соблюдалось соответствие идеалу. Это значит, что шероховатые, асимметричные образцы просто не принимались в расчёт. Они были тем, что сегодня иногда оказывается «мусором» и в работе с данными.
Природа запечатлевает себя
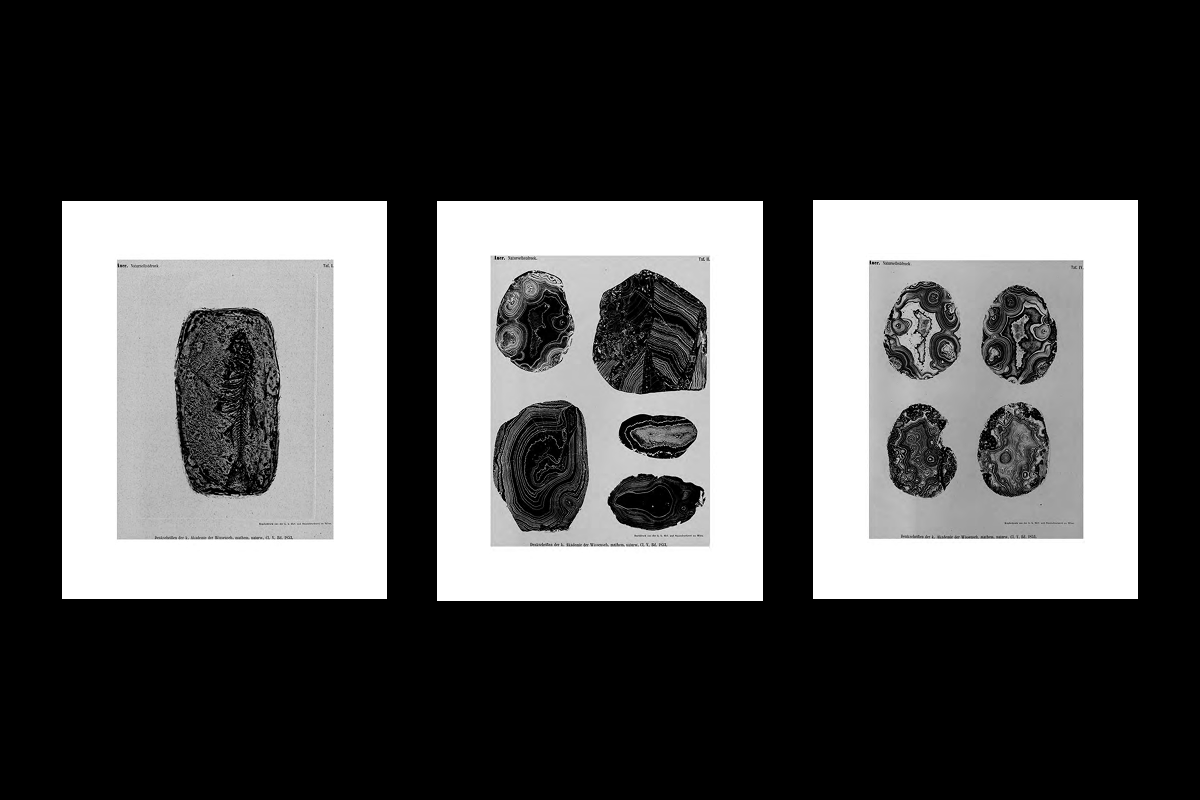
Автопечать листа, Alois Auer, «Die Entdeckung des Naturselbstdruckes», 1853.
В этом нефотографическом методе механического самоотображения объект, который необходимо было воспроизвести, зажимался между медной и свинцовой пластинами, пока не оставлял оттиск на мягком свинце, который впоследствии мог быть отпечатан, как это обычно делали с медной пластины. Изобретатель этого процесса Ауэр хвалился тем, что он знаменует собой третий великий момент в культурной истории человечества после изобретения письма и наборного шрифта Гуттенберга: это было «открытие того, как природа может печатать себя сама».
Архетипы высшего растения и насекомого
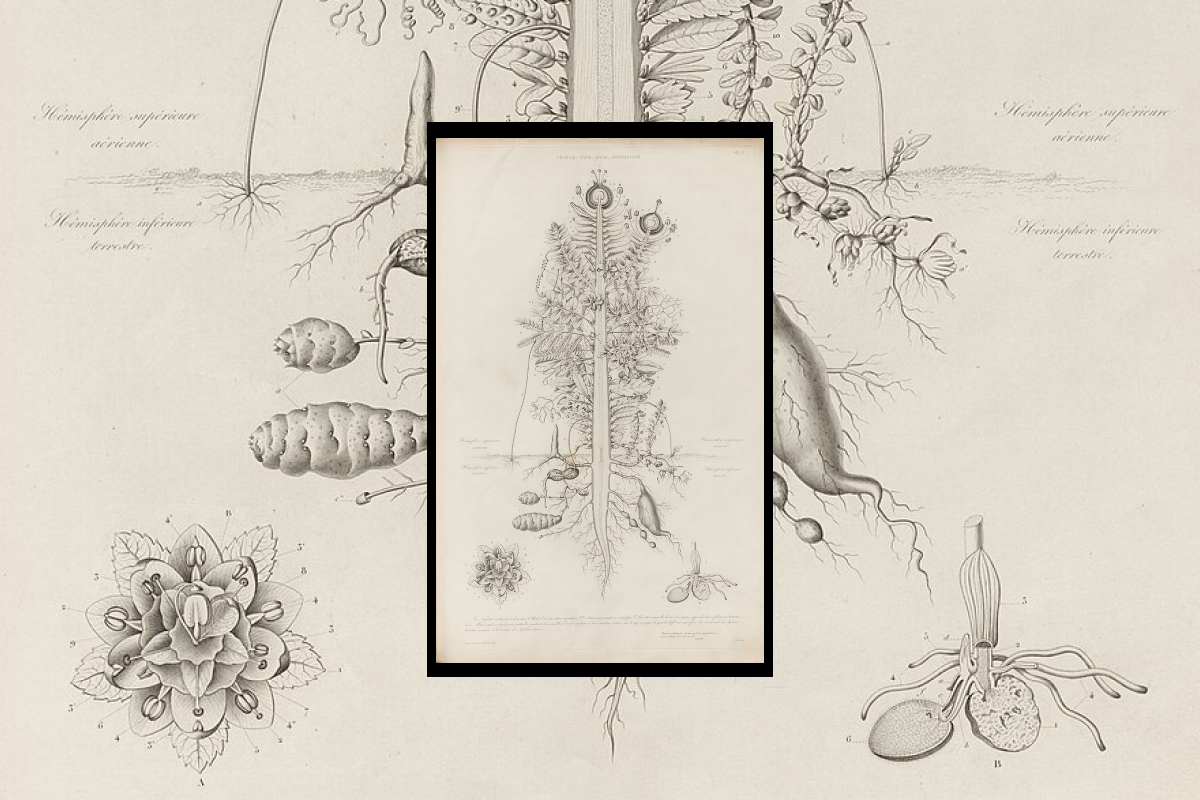
Изображение: Wikimedia Commons
Наброски, сделанные Гёте карандашом и чернилами, окружены его заметками о «трех органических системах» (чувствительной, подвижной и питательной) и их сущностных характеристиках. Гёте обнаруживает Typus Перворастения на всем протяжении растительного царства: «Моя уверенность, что открытая мною общая формула приложима ко всем растениям, только возрастает. С ее помощью я уже могу объяснить наиболее идиосинкратические формы, например страстоцвет, арум, и расположить их параллельно друг другу».
Ранние составители атласов не интерпретировали изменения своих установок и правил. Но мы сегодня знаем, что слова типичный, идеальный, характерный или нормальный не являются синонимами, даже если они отсылают к одной и той же функции стандартизации. И только с XVIII—XIX вв.ека ценной становится объективность — отображение явления таким, каким оно является нашему взгляду. Сначала этим занимались художники, потом всё большее значение имела фотография.
Со временем совершенствовались и возможности хранения, и технического запечатления мира. И важность именно такого подхода сыграла роль в становлении «репрезентативизма» — идеи о том, что данные отражают мир. Мы ещё вернёмся к ней (и к её критике) в следующих занятиях. А пока важно запомнить/ обратить внимание: нам стоит учитывать, что данные могут отличаться при использовании разных инструментов сбора и хранения и разных подходов к тому, что мы считаем достоверным.
Ещё в этом контексте важно учитывать пустоты в данных (data voids). Это материалы, которые не учитываются: нарочно или случайно. Часто обнаружение data voids становится основанием для дискуссии.
Но чтобы всё это вообще считалось научным и обоснованным, должны работать эпистемические авторитеты. Например, чтобы статистика работала: убеждала и толкала на действия СМИ, граждан, политиков, чиновников — она должна быть понята этими группами определенным образом. Она должна приобрести особый авторитет за счёт того, что обращается к «убедительной» визуализации, находиться «в нужное время в нужном месте». произведена авторитетной институцией, и так далее.
Со временем совершенствовались и возможности хранения, и технического запечатления мира. И важность именно такого подхода сыграла роль в становлении «репрезентативизма» — идеи о том, что данные отражают мир. Мы ещё вернёмся к ней (и к её критике) в следующих занятиях. А пока важно запомнить/ обратить внимание: нам стоит учитывать, что данные могут отличаться при использовании разных инструментов сбора и хранения и разных подходов к тому, что мы считаем достоверным.
Ещё в этом контексте важно учитывать пустоты в данных (data voids). Это материалы, которые не учитываются: нарочно или случайно. Часто обнаружение data voids становится основанием для дискуссии.
Но чтобы всё это вообще считалось научным и обоснованным, должны работать эпистемические авторитеты. Например, чтобы статистика работала: убеждала и толкала на действия СМИ, граждан, политиков, чиновников — она должна быть понята этими группами определенным образом. Она должна приобрести особый авторитет за счёт того, что обращается к «убедительной» визуализации, находиться «в нужное время в нужном месте». произведена авторитетной институцией, и так далее.
Например, данные из базы, собранной филологами, не будут полностью подходить библиографам, и наоборот. У библиографов будет много категорий, которые нужны для систематизации изданий, но не содержат информации о том, что внутри книги: проза, стихотворения, переписки.
Если говорить ещё и о технически опосредованных данных, например, о том, что является «цифровыми следами» или материалами, собираемыми через камеры, то нам нужно учитывать и ограничения самих платформ/средств записи.
Например, со временем меняется и платформа, и режим доступа. Так, на популярном сайте-форуме Reddit в 2023 году обновились условия доступа к автоматическому скачиванию данных с платформы для разработчиков, модераторов и исследователей.
Наконец, сами объекты исследований могут влиять на то, какие есть категории. Например, в статье Сергея Скобелева «Демография как политика. Коренное население Сибири в составе Российской империи и СССР: динамика численности как отражение политики центра» есть сюжет о том, что стоит учитывать изменение идентичности людей:
В 70-е годы XVIII века насчитывалось 827 человек томских телеутов, а в 1858-м их осталось только 549 (падение более чем на треть), что объяснялось принятием ими ислама и причислением в отчетной документации к другой конфессиональной группе — томским татарам <…> В 90-е годы XX века наметились и обратные процессы. <…> Так, активисты национального движения телеутов добились в 1991 году разрешения сменить прежнюю запись в паспортах „татарин“ на «телеут», и таким образом в список народов России был внесен новый этноним.
Скобелев, 2002
/ итак, краткий итог: откуда берутся данные
- у нас должны быть системы различий: сырых, приготовленных, гнилых данных: хороших и плохих, чистых и грязных, с пустотами и без оных.
- добродетели, которые оправдывают определённый вид сбора данных + эпистемические авторитеты, которые их поддерживают
- соответствующие им всем понятия и методы пополнения табличек, каталогов и других систем фиксации
- технические возможности должны подходить способу сбора данных, и их последующем использованию
- источники данных не должны сопротивляться и создавать альтернативную картину мира.
И да, конечно, у нас должны быть институции, где всё это может происходить, а также специалисты, которые умеют собирать и анализировать данные. И процессы, к которым всё это можно применить.
Так у нас появляются данные! Или взятые?
Мы подошли к важному различению: Data/Capta. Capta — это «взятые». Помните Джоанну Дракер? Это она придумала такое различение в своей статье 2011 года «Humanities Approaches to Graphical Display».
Базовая идея очень проста: любые данные — это не то, что нам дано (datum, лат.), а то, что мы берём (captum, лат). И не только. Джереми Хансингер предлагает в своей статье big capta другие варианты: acta, capta, cognata, communicata, sumpta, and inventa. Завершает тем, что капта — не идеальна, но лучше, чем дата. А идеальным ему представляется термин «сумпта» (значащие) (Hunsinger, 2020).
А у Роба Китчина (Kitchin, Dodge, 2011) есть статья, где он использует понятия капты вместо даты. Он объясняет это так:
1. capta (capta — это элементы, отобранные и собранные из суммы всех потенциальных данных, где данные — это общая сумма фактов, относящихся к объекту; другими словами, в отношении человека данные — это все, что можно узнать об этом человеке, capta — это то, что избирательно собирается посредством измерения).
2. captabases (набор capta, хранящийся в виде областей, обычно в табличной форме, к которому легко получить доступ, которым можно управлять, обновлять, запрашивать и анализировать; традиционно называемый базой данных, он был переименован, чтобы показать, что на самом деле он содержит capta, а не данные).
Попробуйте использовать эту игру с понятиями: вместо слова «данные» использовать «взятые». Необязательно сразу делать это публично, в быту и на работе. Но попробуйте начать с небольших экспериментов.
/ обработка данных
И да, сами культуры работы с данными и алгоритмами, которые их «добывают» и «обрабатывают» тоже отличаются.
Но их объединяет поиск закономерностей в том, что мы видим с помощью инструментов для представления данных.
Здесь нас ждёт подвох: поиск закономерностей — это часто поиск причинности (каузальности). Видя устойчивые совпадения, мы невольно прочерчиваем между ними причинно-следственные отношения. Например, если мы видим, что люди идут под зонтами, мы знаем, что они делают это потому, что пошёл дождь. Но не наоборот.
Если с погодой и нашими действиями всё более или менее линейно, в социальной жизни такие прямые отношения причины и следствия — скорее редкость. Почему дети больше отвлекаются? Из-за планшетов или из-за того, что меняется стиль воспитания? Или стиль воспитания меняется ещё по какой-то причине? Или планшеты чаще используют родители, чтобы занять ребёнка надолго хоть чем-то?
Ещё несколько толковых примеров можно найти вот здесь. Иногда это соотносят с работой мозга, как в этих примерах. Иногда — с культурой и конкретными социальными и эпистемологическими условиями. Но общий принцип очень важен: не путайте совпадения с причинностью!
(обратите внимание на график внизу, он показывает, что бывает, если всё же путать; много забавных и грустных примеров в этой подборке странных корреляций).
Но их объединяет поиск закономерностей в том, что мы видим с помощью инструментов для представления данных.
Здесь нас ждёт подвох: поиск закономерностей — это часто поиск причинности (каузальности). Видя устойчивые совпадения, мы невольно прочерчиваем между ними причинно-следственные отношения. Например, если мы видим, что люди идут под зонтами, мы знаем, что они делают это потому, что пошёл дождь. Но не наоборот.
Если с погодой и нашими действиями всё более или менее линейно, в социальной жизни такие прямые отношения причины и следствия — скорее редкость. Почему дети больше отвлекаются? Из-за планшетов или из-за того, что меняется стиль воспитания? Или стиль воспитания меняется ещё по какой-то причине? Или планшеты чаще используют родители, чтобы занять ребёнка надолго хоть чем-то?
Ещё несколько толковых примеров можно найти вот здесь. Иногда это соотносят с работой мозга, как в этих примерах. Иногда — с культурой и конкретными социальными и эпистемологическими условиями. Но общий принцип очень важен: не путайте совпадения с причинностью!
(обратите внимание на график внизу, он показывает, что бывает, если всё же путать; много забавных и грустных примеров в этой подборке странных корреляций).
Есть и более тонкие особенности работы с методом и анализом. Например, Мэтью Джонс (Jones, 2018) пишет об интерпретативной, причинной и механистичной моделях работы с данными. Это примерно понятно из здравого смысла:
Джонс тут опирается на идею Лео Брейнмана о статистике. Брейнман (Breiman, 2001) описал две культуры использования статистических моделей, которые существуют для того, чтобы делать выводы: одна предполагает более научный, а вторая — инженерный подход. Первая основана на том, что механизмы извлечения данных работают с понятной и однообразной реальностью, а сами усовершенствуются. Другая — что реальность изменчива, и механизмы обращения к ней тоже меняются. Для социальных учёных и философии науки эта мысль не нова: об этом же спорил Эмиль Дюркгейм с американскими прагматистами, эту же сложность реальности описывали Гегель и Спиноза.
Изучая историю науки, мы понимаем, что любой подход может измениться. Например, цифровизация и автоматизация — это два разных процесса, и они могут требовать работы с разными данными. Раз так, нам важно понять общие закономерности (!) и предпосылки.
Но всё может измениться ещё сильнее. Неслучайно «большие данные» часто сравнивают с астрологией. Ведь и там и там в основе — обращение к множеству совпадений, из которых происходит понимание того, как надо действовать. Да и история исключения астрологии из числа наук — тёмное дело. Если вы хотите подумать про философские и исторические основания этого процесса, можно почитать Михаила Куртова. Или послушать его лекцию.
- причинная: можно выявлять причинно-следственные связи;
- интерпретативная: а интерпретировать можно и без поиска причин;
- механистичная: смотреть на модели как на простые тенденции/закономерности, которые можно использовать.
Джонс тут опирается на идею Лео Брейнмана о статистике. Брейнман (Breiman, 2001) описал две культуры использования статистических моделей, которые существуют для того, чтобы делать выводы: одна предполагает более научный, а вторая — инженерный подход. Первая основана на том, что механизмы извлечения данных работают с понятной и однообразной реальностью, а сами усовершенствуются. Другая — что реальность изменчива, и механизмы обращения к ней тоже меняются. Для социальных учёных и философии науки эта мысль не нова: об этом же спорил Эмиль Дюркгейм с американскими прагматистами, эту же сложность реальности описывали Гегель и Спиноза.
Изучая историю науки, мы понимаем, что любой подход может измениться. Например, цифровизация и автоматизация — это два разных процесса, и они могут требовать работы с разными данными. Раз так, нам важно понять общие закономерности (!) и предпосылки.
Но всё может измениться ещё сильнее. Неслучайно «большие данные» часто сравнивают с астрологией. Ведь и там и там в основе — обращение к множеству совпадений, из которых происходит понимание того, как надо действовать. Да и история исключения астрологии из числа наук — тёмное дело. Если вы хотите подумать про философские и исторические основания этого процесса, можно почитать Михаила Куртова. Или послушать его лекцию.
/ данные и представление о мире. визуализация
Большие массивы данных редко существуют как что-то, что можно целиком увидеть или прочитать. Для большинства людей данные становятся «заметны» только тогда, когда кто-то превращает их в карту, график, диаграмму или инфографику. Иными словами, мы чаще сталкиваемся не с данными как таковыми, а с их визуализацией.
Визуализация действует почти без слов: ее убедительность как будто бы происходит не из проясняющих комментариев, а данные представлены так, словно «говорят сами за себя». Особенно если сделана визуализация сделана впечатляюще.
Но визуализация имеет значение. Вот здесь вы можете посмотреть или послушать доклады на эту тему. Мы советуем вам послушать третий доклад, Хелен Кеннеди: нам кажется интересным мысль Хелен о том, что визуализация часто направлена на непрофессионалов, и настроена на то, чтобы воздействовать на людей. Поэтому многие приёмы при визуализации направлены именно на публичный эффект, а не какую-то другую ценность (например, развитие диалога или критического отношения).
Визуализация действует почти без слов: ее убедительность как будто бы происходит не из проясняющих комментариев, а данные представлены так, словно «говорят сами за себя». Особенно если сделана визуализация сделана впечатляюще.
Но визуализация имеет значение. Вот здесь вы можете посмотреть или послушать доклады на эту тему. Мы советуем вам послушать третий доклад, Хелен Кеннеди: нам кажется интересным мысль Хелен о том, что визуализация часто направлена на непрофессионалов, и настроена на то, чтобы воздействовать на людей. Поэтому многие приёмы при визуализации направлены именно на публичный эффект, а не какую-то другую ценность (например, развитие диалога или критического отношения).
Хороший пример — проект Portraits of Population. Создатели проекта рассказывают, как во второй половине XX века индийская служба переписи населения начала публиковать специальные серии «портретов населения» — наглядные визуализации, рассчитанные не на специалистов, а на широкую аудиторию. Их задача заключалась в том, чтобы убедить граждан обратить внимание на проблему роста населения.
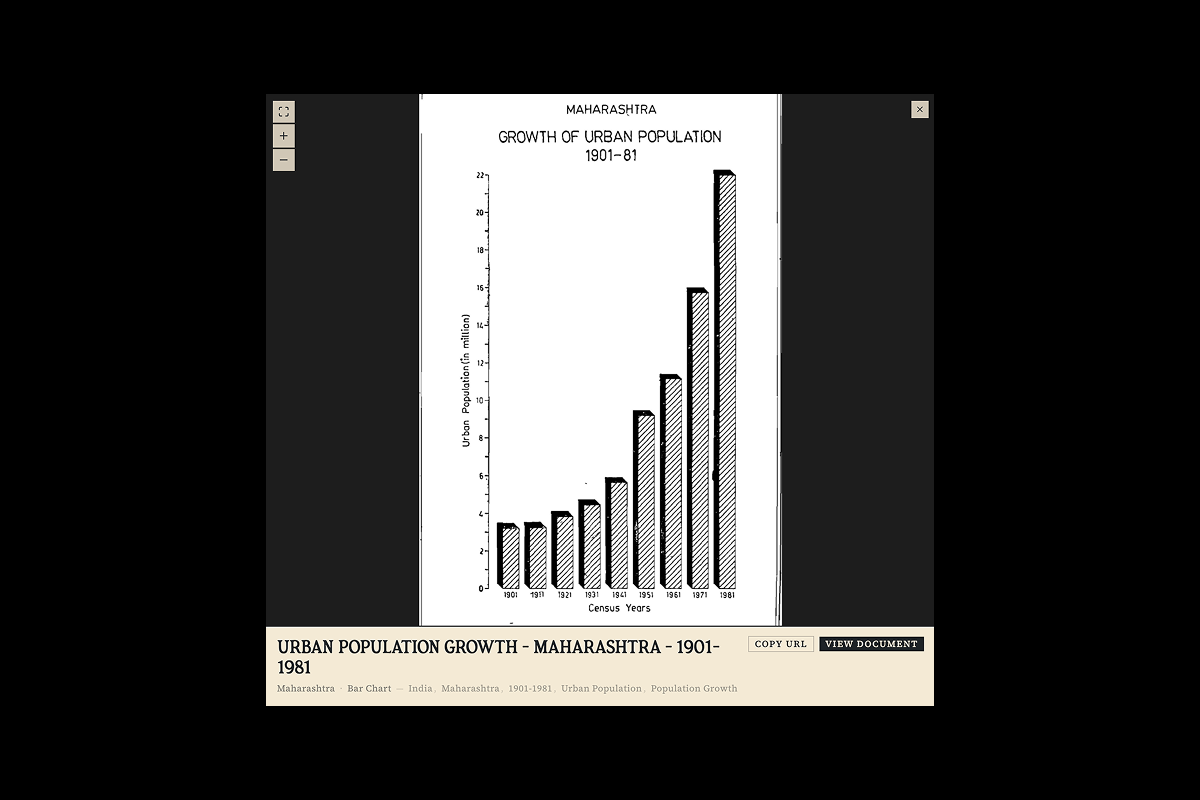
Иногда инструменты визуализации используют для получения нового знания. В цифровых гуманитарных исследованиях, например, сетевые графы помогают увидеть связи между людьми, произведениями или архивами, которые трудно заметить другими способами.
- Один из самых известных примеров такого подхода появился задолго до компьютеров. В середине XIX века врач Джон Сноу нанёс на карту случаи заболевания холерой в Лондоне и обнаружил, что большинство из них сосредоточено вокруг одной водоразборной колонки на Брод-стрит. Благодаря удалось увидеть закономерность и предположить источник распространения болезни. Сегодня этот пример часто приводят как один из первых случаев, когда визуализация помогла ответить на исследовательский вопрос.
- Ещё примеры таких визуализаций приводит Бюро Горбунова: https://bureau.ru/soviet/20231115/.
- Пример из мира цифровых гуманитарных наук: в драме Борис Годунов роль Гаврилы Пушкина как связующего два пространства пьесы персонажа подсвечивается визуализацией сетевого анализа (мы об этом прочитали в блоге Даниила Скоринкина в Телеграме: https://t.me/fckndh/220).
Визуализация и помогает увидеть закономерности, и формирует их. Любая визуализация строится на выборе: что считать важным, какие объекты сравнивать, какую шкалу использовать, где провести границы категорий и что оставить за пределами изображения.
Именно на это обращает внимание исследовательница Джоанна Дракер. Она пишет, что большинство привычных способов визуализации возникло в естественных науках и предполагает, что данные точны, категории устойчивы, а неопределённость можно игнорировать. Но гуманитарные исследования редко работают с такими материалами. Даты могут быть приблизительными, авторство — спорным, границы явлений — размытыми, а сами интерпретации — конкурирующими. Если представить такие материалы в виде обычного графика или карты, создаётся впечатление большей определённости, чем есть на самом деле.
Именно на это обращает внимание исследовательница Джоанна Дракер. Она пишет, что большинство привычных способов визуализации возникло в естественных науках и предполагает, что данные точны, категории устойчивы, а неопределённость можно игнорировать. Но гуманитарные исследования редко работают с такими материалами. Даты могут быть приблизительными, авторство — спорным, границы явлений — размытыми, а сами интерпретации — конкурирующими. Если представить такие материалы в виде обычного графика или карты, создаётся впечатление большей определённости, чем есть на самом деле.
Например, вот что отмечает Тимур Валетов в сборнике Парад цифровых гуманитарных проектов про картографические проекты:
Поскольку авторы таких проектов ориентированы на работу с картами исторического времени, им приходится решать сложные источниковедческие вопросы, а если они заходят в средневековый период, то в полный рост встают не только вопросы о правильном начертании границ, но даже и о смысле понятия государственной границы и даже самого понятия «государство». История знает огромное число разнообразных статусов той или иной территории; в историю плохо вписывается простое понятие о том, что на карте представлена территория нескольких независимых государств, которую и следует раскрасить в разные цвета (Парад цифровых гуманитарных проектов, 2025. с. 171).
Поэтому Дракер предлагает не просто использовать существующие инструменты визуализации, а разрабатывать новые способы представления гуманитарных данных. Такие визуализации могли бы показывать неопределённость, множественность интерпретаций и степень уверенности исследователя, а не скрывать их.
/ визуализация напоследок
Визуализация не обязательно должна быть инструментом убеждения или доказательства. Она может стать способом рассказать историю о себе, понаблюдать за собственными привычками или поделиться опытом с другим человеком. Хороший пример — проект Dear Data, созданный дизайнерами Джорджией Лупи и Стефани Позавец.
Нарисуйте график, который показывает, как прошёл ваш день, но используйте не астрономическое время, а собственные ощущения. Например, пусть длиннее окажутся моменты, которые тянулись бесконечно, а короче — те, что пролетели незаметно. Что изменилось? Какие особенности такого опыта удалось показать, а какие — наоборот, исчезли?
/ источники
- Boellstorff, T. (2013). Making big data, in theory. First Monday, 18(10). https://doi.org/10.5210/fm.v18i10.4869
- boyd, d., & Crawford, K. (2012). Critical questions for big data: Provocations for a cultural, technological, and scholarly phenomenon. Information, Communication & Society, 15(5), 662−679. https://doi.org/10.1080/136 9118X.2012.678 878
- Breiman, L. (2001). Statistical modeling: The two cultures. Statistical Science, 16(3), 199−231. https://doi.org/10.1214/ss/1 009 213 726
- Drucker, J. (2011). Humanities approaches to graphical display. Digital Humanities Quarterly, 5(1), 1−21.
- Gitelman, L. (Ed.). (2013). Raw data is an oxymoron. MIT Press.
- Hunsinger, J. (2020). Big capta? In Second international handbook of Internet research (pp. 767−784). Springer. https://doi.org/10.1007/978−94−024−1555−137
- Kitchin, R., & Dodge, M. (2014). Code/space: Software and everyday life. MIT Press.
- Markham, A. N. (2013). Undermining 'data': A critical examination of a core term in scientific inquiry. First Monday, 18(10). https://doi.org/10.5210/fm.v18i10.4868
- Markham, A. N. (2020). Taking data literacy to the streets: Critical pedagogy in the public sphere. Qualitative Inquiry, 26(2), 227−237. https://doi.org/10.1177/1 077 800 419 859 024
- Rosenberg, D. (2013). Data before the fact. In L. Gitelman (Ed.), Raw data is an oxymoron (pp. 15−40). MIT Press.
- Strassheim, H., & Korinek, R.-L. (2016). Cultivating 'nudge': Behavioural governance in the UK. In Knowing governance (pp. 107−126). Springer.
- Vis, F. (2013). A critical reflection on Big Data: Considering APIs, researchers and tools as data makers. First Monday, 18(10). https://doi.org/10.5210/fm.v18i10.4878
- Wernimont, J. (2019). Numbered Lives: Life and Death in Quantum Media. The MIT Pres.
- Галисон, П., & Дастон, Л. (2018). Объективность. Новое литературное обозрение.
- Скобелев, С. Г. (2002). Демография как политика. Коренное население Сибири в составе Российской империи и СССР: динамика численности как отражение политики центра. Ab Imperio, (2), 173−198.
- Парад цифровых гуманитарных проектов: монография / А. Е. Арефьев, Т. А. Базарова, Е. В. Баранова [и др.]; отв. ред. А. Ю. Володин; Красноярск: СФУ, 2025.