2. инфраструктуры: от архивов к ИИ
содержание:
Архивы — это и места хранения прошлого, и сложные инфраструктуры. От бумажных карточек и музейных каталогов до больших данных и искусственного интеллекта — способы сохранять, описывать и открывать знания меняют не только технологии, но и само понимание памяти.
/ данные в культуре — это память?
Сложно представить современную культурную жизнь без институций (музеев, архивов, библиотек), которые сохраняют свидетельства прошлого: собирают документы и артефакты, классифицируют их, хранят, а затем показывают посетителям и зрителям. Культура и наука вообще неотделимы от форм, которые делают прошлое доступным в настоящем. Но эти формы всё время меняются! Как же быть? Остаётся ли культура прежней, или она связана с техникой прежних времён и классических институций?
Часто саму сферу культуры, которая затрагивается цифровыми трансформациями, обозначают по-английски аббревиатурой GLAM: Galleries, Libraries, Archives, Museums (ГЛАМ: галереи, библиотеки, архивы, музеи). Когда к ним добавляются дата-центры и алгоритмы, получается, что мы говорим уже не только о коллекциях и экспозициях, но и о таблицах, данных, статистике. Это уже не первый год осмысляется в рамках цифровых гуманитарных исследований: оптимистично (ведь происходит увеличение возможностей доступа и пополнения коллекций) или с опаской.
Например, вот статья про коллекции как данные, где выражается скепсис по поводу того, что данные — это то же, что и коллекции: Datafication and Cultural Heritage Collections Data Infrastructures: Critical Perspectives on Documentation, Cataloguing and Data-sharing in Cultural Heritage Institutions | Journal of Open Humanities Data.
Когда мы обращаем внимание на изменение формы, то учимся видеть не только саму по себе трансформацию, но и работу, которая за ней стоит. А ещё начинаем распознавать объекты культурного наследия или предметы из архивных фондов как что-то похожее. Например, понимать всё это не только как данные, но и как уже существующие материалы, отражающие прошлое.
Collection is data (коллекция как данные) — это довольно развитое движение среди тех, кто работает с культурными данными. Участники движения разрабатывают подходы создания или изменения коллекций внутри музеев, архивов и галерей, которые удобны для машинной обработки разного типа: например, для синхронизации с разными цифровыми системами хранения, автоматического чтения и т. д.
Но значит ли это, что данные — это память? Не совсем. Хорошо увидеть эту разницу позволяет работа Аннетт Маркхэм и Габриэль Перейры Experimenting with Algorithms and Memory-Making (2019). Они описывают инсталляцию Memory Glitch: женщина по имени Трине рассказала исследователям историю немецкой оккупации своего города во время войны, а затем её рассказ пропустили через три разных алгоритма.
Первый алгоритм расшифровывал речь в текст — и терял акцент и интонацию. Второй пикселизировал видео тем сильнее, чем ближе к Трине подходил зритель. Третий превращал движения её рук в танцующие точки и иногда путал её жесты с движениями интервьюера. Ни одна из трёх версий не давала связного рассказа.
Для авторов это становится способом показать важную вещь: данные — не память, а след памяти после серии преобразований. На каждом этапе что-то теряется, а что-то добавляется — в соответствии с логикой инструмента, формата или алгоритма. Память в этом смысле никогда не помещается в артефакт целиком: она существует не только в хранилище, но и в отношениях, контексте и процессе её воспоминания (Подробнее: Markham, Pereira, 2019).
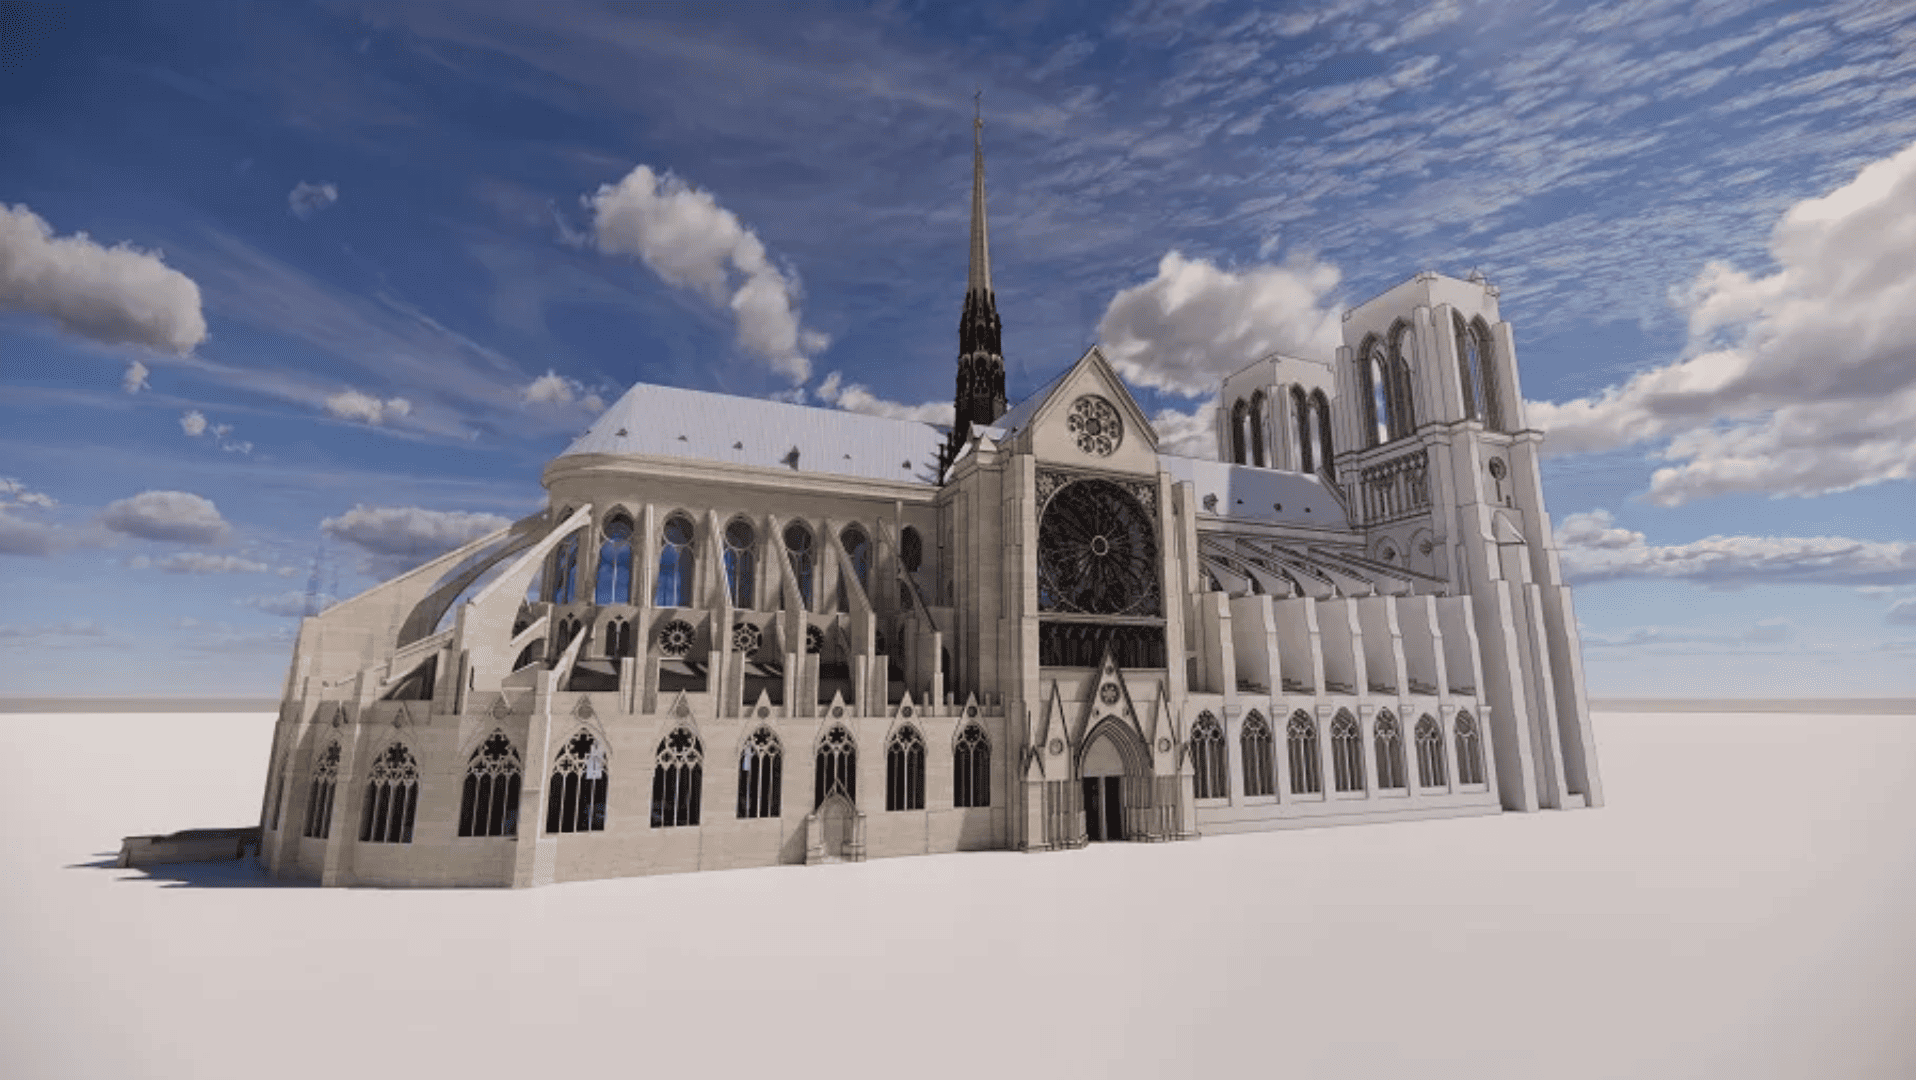
Но почему вообще сегодня память так тесно связывают с данными? Ответ отчасти в масштабе: мы живём в момент, когда цифровизация стала фактически синонимом заботы о наследии. UNESCO ещё в 2003 году приняла Хартию о сохранении цифрового наследия, прямо признав: часть человеческого знания рождается уже цифровой или переводится в цифру с аналоговых носителей — и рискует быть утраченной просто из-за устаревания форматов. А толчком к массовой цифровизации нередко становятся именно потери: пожар в Национальном музее Бразилии в 2018 году, пожар в Нотр-Дам годом позже — оба случая заставили институции по всему миру заново пережить страх, что физический носитель памяти может исчезнуть безвозвратно, а цифровая копия — нет.
Первый алгоритм расшифровывал речь в текст — и терял акцент и интонацию. Второй пикселизировал видео тем сильнее, чем ближе к Трине подходил зритель. Третий превращал движения её рук в танцующие точки и иногда путал её жесты с движениями интервьюера. Ни одна из трёх версий не давала связного рассказа.
Для авторов это становится способом показать важную вещь: данные — не память, а след памяти после серии преобразований. На каждом этапе что-то теряется, а что-то добавляется — в соответствии с логикой инструмента, формата или алгоритма. Память в этом смысле никогда не помещается в артефакт целиком: она существует не только в хранилище, но и в отношениях, контексте и процессе её воспоминания (Подробнее: Markham, Pereira, 2019).
Но почему вообще сегодня память так тесно связывают с данными? Ответ отчасти в масштабе: мы живём в момент, когда цифровизация стала фактически синонимом заботы о наследии. UNESCO ещё в 2003 году приняла Хартию о сохранении цифрового наследия, прямо признав: часть человеческого знания рождается уже цифровой или переводится в цифру с аналоговых носителей — и рискует быть утраченной просто из-за устаревания форматов. А толчком к массовой цифровизации нередко становятся именно потери: пожар в Национальном музее Бразилии в 2018 году, пожар в Нотр-Дам годом позже — оба случая заставили институции по всему миру заново пережить страх, что физический носитель памяти может исчезнуть безвозвратно, а цифровая копия — нет.
изображение: Autodesk
Возьмём пример — проект «Прожито». Проект работает с дневниками: рукописными тетрадями, письмами и другими документами, которые люди вели десятилетиями. Это источники — тексты с конкретным автором, судьбой, почерком и датой. Они существуют независимо от исследовательского проекта: их находят, передают, оцифровывают и делают доступными для работы (подробнее на сайте).
В гуманитарных исследованиях привычно работать с такими источниками, не называя их данными. Но в цифровых гуманитарных исследованиях тот же документ может стать основой для набора данных: например, его можно:
В этом случае данные — не сам дневник, а его определённое цифровое представление, организованное так, чтобы с ним можно было выполнять определённые операции: искать, сопоставлять, считать или анализировать.
Поэтому данные тут — это способ представить материал в определённой структуре. Данные отличаются от документа не только тем, что они находятся «в компьютере». Данные задают определённый способ видеть и организовывать материал.
- расшифровать,
- разметить,
- представить в виде таблицы с полями «автор», «дата», «текст записи».
В этом случае данные — не сам дневник, а его определённое цифровое представление, организованное так, чтобы с ним можно было выполнять определённые операции: искать, сопоставлять, считать или анализировать.
Поэтому данные тут — это способ представить материал в определённой структуре. Данные отличаются от документа не только тем, что они находятся «в компьютере». Данные задают определённый способ видеть и организовывать материал.
/ как хранится то, что мы знаем
Документы хранятся в архивах. При этом слово «архив» может звучать довольно расплывчато. Это может быть институциональное хранилище, но архивная логика работает и в повседневной жизни: мы организуем вещи, документы и воспоминания с помощью классификаций, папок, ящиков и привычки раскладывать всё по местам.
А для любой такой организации нужна не только логика, но и материальная инфраструктура — конкретные вещи, которые делают хранение возможным.
А для любой такой организации нужна не только логика, но и материальная инфраструктура — конкретные вещи, которые делают хранение возможным.
Хороший доцифровой пример здесь — Поль Отле. Когда на рубеже XIX и XX веков он разрабатывал универсальную систему классификации, он создавал не только метод. Он придумал специальные карточки определённого формата и мебель для их хранения. Без этих шкафов и карточек система просто не могла бы работать. Идея классификации нуждалась в конкретной материальной инфраструктуре, чтобы существовать в мире.
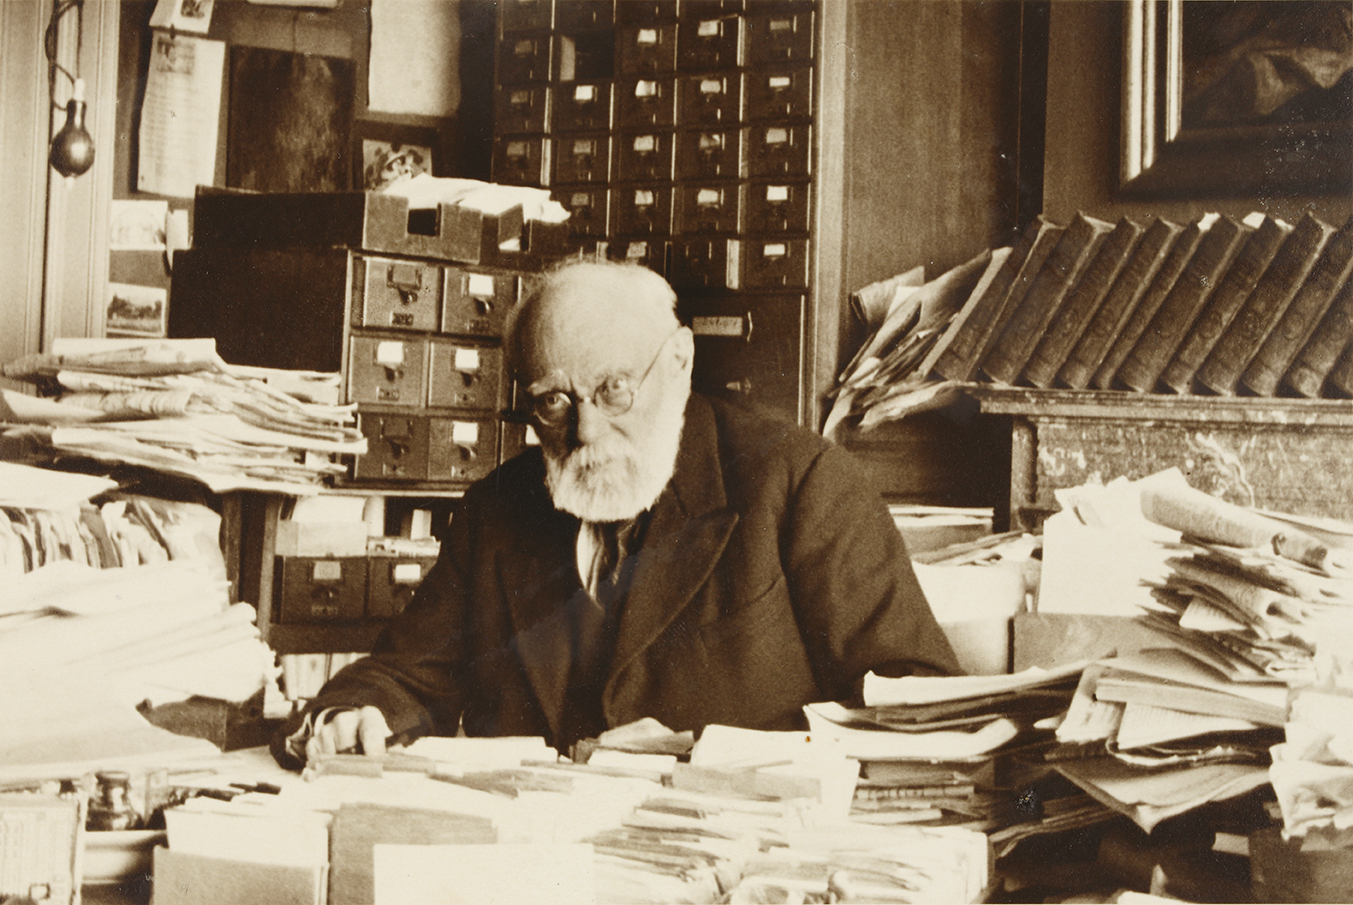
Поль Отле в своём кабинете. Изображение: Wikimedia Commons
Есть и ещё одна важная вещь: сохранённое не начинает автоматически что-либо значить. Ему требуется медиация — посредничество, которое позволяет понять, что это такое, откуда оно взялось и как им пользоваться. Кристин Боргман, Андреа Шарнхорст и Милена Голшан в статье Digital Data Archives as Knowledge Infrastructures пишут об этом применительно к цифровым архивам данных: они становятся инфраструктурами знания только тогда, когда кто-то обеспечивает их интерпретацию, обмен и повторное использование. Иначе перед нами остаётся просто набор файлов, понятных в лучшем случае тому, кто их туда положил (Borgman, Scharnhorst, Golshan, 2019).
/ архивы и наука
Считается, что историзм как особый способ работы с прошлым формируется в XIX веке, и многие исследователи связывают этот поворот с Леопольдом фон Ранке. Ранке говорил о том, что историю нужно писать не по хроникам и легендам, а по первоисточникам — архивным документам, стремясь показать прошлое таким, «как оно было на самом деле» (wie es eigentlich gewesen).
В этот момент архив перестаёт быть просто административным хранилищем. Он становится эпистемологическим фундаментом дисциплины — местом, откуда историк получает материалы и основания для знания о прошлом.
В этот момент архив перестаёт быть просто административным хранилищем. Он становится эпистемологическим фундаментом дисциплины — местом, откуда историк получает материалы и основания для знания о прошлом.
Если историк работает с архивом, то насколько знание о прошлом зависит от того, что именно оказалось в архиве?
Но в XIX веке «мода» на архивы распространяется далеко за пределы истории. Роль научных архивов в науке исследовала уже известная нам с вами Лоррейн Дастон. Она показала, что классические науки девятнадцатого века вообще неотделимы от своих архивов. Любая наука опирается на коллективный эмпиризм: учёный не может лично наблюдать всё, что происходило до него или происходит в других местах. Поэтому он зависит от наблюдений других исследователей, которые были зафиксированы, сохранены и сделаны доступными в атласах, архивах, экспозициях научных музеев (Daston, 2012).
Дастон пишет об этом в работе The Immortal Archive: памятники науки XIX века были не столько архитектурными, сколько архивными. Учёные создавали опубликованные сборники и механические копии рабочих материалов, рассчитывая, что обеспечат будущие поколения объектами для исследования на годы вперёд, и другие учёные смогут продолжить исследования спустя десятилетия и даже столетия (Daston, 2017).
Но здесь возникает ещё одна особенность: каждая дисциплина сама решает, что для неё важно сохранять. Архив поэтому не просто накапливает документы. Он фильтрует их через дисциплинарную оптику: определяет, что считать фактом, что — шумом, что стоит записывать, а что можно оставить за пределами записи.
Дастон пишет об этом в работе The Immortal Archive: памятники науки XIX века были не столько архитектурными, сколько архивными. Учёные создавали опубликованные сборники и механические копии рабочих материалов, рассчитывая, что обеспечат будущие поколения объектами для исследования на годы вперёд, и другие учёные смогут продолжить исследования спустя десятилетия и даже столетия (Daston, 2017).
Но здесь возникает ещё одна особенность: каждая дисциплина сама решает, что для неё важно сохранять. Архив поэтому не просто накапливает документы. Он фильтрует их через дисциплинарную оптику: определяет, что считать фактом, что — шумом, что стоит записывать, а что можно оставить за пределами записи.
Встречались ли вы с таким разнообразием подходов? Как вы думаете, в чём особенность и разница подхода историка, библиографа и филолога, например, к одной и той же рукописи? Почему у лингвистов и социологов могут возникать разночтения при работе с фольклорным материалом? Мы ещё вернёмся к примерам дисциплин и институциональных архивов, а пока предлагаем подумать над этими вопросами.
/ архив как инфраструктура
Сегодня мы уже хорошо понимаем, что архив — не пыльный склад, а сложная инфраструктура. Сьюзен Ли Стар в The Ethnography of Infrastructure предлагает смотреть на инфраструктуру не как на набор труб, серверов или дорог, а как на отношения между людьми, практиками, технологиями, стандартами и организациями (Star, 1999).
У инфраструктуры есть особое свойство: она становится невидимой именно потому, что мы к ней привыкаем. Мы не замечаем архивную систему, пока она исправно работает. Она становится видимой, когда что-то ломается: файл невозможно открыть, документ оказывается недоступен, исчезает формат или перестаёт работать система поиска.
Брайан Ларкин в The Politics and Poetics of Infrastructure добавляет к этому ещё один слой — политику доступа. Инфраструктура не только технически организует хранение, но и определяет, кто получит доступ к сохранённому, а кто нет. И это не менее важная часть её работы, чем само хранение (Larkin, 2013).
У инфраструктуры есть особое свойство: она становится невидимой именно потому, что мы к ней привыкаем. Мы не замечаем архивную систему, пока она исправно работает. Она становится видимой, когда что-то ломается: файл невозможно открыть, документ оказывается недоступен, исчезает формат или перестаёт работать система поиска.
Брайан Ларкин в The Politics and Poetics of Infrastructure добавляет к этому ещё один слой — политику доступа. Инфраструктура не только технически организует хранение, но и определяет, кто получит доступ к сохранённому, а кто нет. И это не менее важная часть её работы, чем само хранение (Larkin, 2013).
Посмотреть на архив как инфраструктуру могут не только специалисты в работе с культурным наследием, но и пользователи любого телефона или компьютера. Раздел «Архив» в наших гаджетах работает так же, как и любой другой: с поправкой на то, что разработку классификаций делают компании-производители. Иногда они меняют эти принципы, и, например, вводят распознавание лиц и геолокаций, формируя альбомы, полные «пушистых друзей» вроде собак и кошек или «этот день три года назад».
Присмотритесь: пользуетесь ли вы архивными функциями в телефоне или компьютере? Создаёте ли вы коллекции самостоятельно или настраиваете алгоритмы? В чём это похоже на практики, что представляет собой профессиональных архивистов?
Режим доступа, в свою очередь, во многом предопределён самим типом институций памяти, о которых мы уже сегодня вспоминали. Архив, библиотека и музей изначально по-разному представляют себе, каким образом посетителям следует предоставлять доступ к своим коллекциям. Музей, например, работает через выставки и экспозиции: он отбирает часть коллекции и выстраивает из неё определённую историю, которая к тому же часто носит временный характер. Для архива, напротив, принципиально важна возможность обеспечить доступ ко всему тому, что в нём хранится, даже если на практике этот доступ может быть ограничен множеством условий.
Эти различия влияют и на логику оцифровки. Оцифровать музейную коллекцию — не обязательно значит просто сделать цифровые копии всех объектов и открыть к ним одинаковый доступ. Цифровая инфраструктура может воспроизводить выставочную логику, выделяя отдельные объекты, объединяя их в тематические коллекции и предлагая пользователю определённый способ их увидеть. Архивная оцифровка, напротив, может быть ориентирована на создание максимально полного и систематического доступа к материалам, на сохранение их связей и контекста. Поэтому сама цифровизация не устанавливает единый режим доступа: то, что именно оцифровывается, как это описывается и каким образом становится доступным, зависит от институциональной логики, которая существовала ещё до появления цифровых технологий.
Эти различия влияют и на логику оцифровки. Оцифровать музейную коллекцию — не обязательно значит просто сделать цифровые копии всех объектов и открыть к ним одинаковый доступ. Цифровая инфраструктура может воспроизводить выставочную логику, выделяя отдельные объекты, объединяя их в тематические коллекции и предлагая пользователю определённый способ их увидеть. Архивная оцифровка, напротив, может быть ориентирована на создание максимально полного и систематического доступа к материалам, на сохранение их связей и контекста. Поэтому сама цифровизация не устанавливает единый режим доступа: то, что именно оцифровывается, как это описывается и каким образом становится доступным, зависит от институциональной логики, которая существовала ещё до появления цифровых технологий.
/ архивы и активизм
Если архив — не нейтральный склад, а система, которая отбирает, описывает и регулирует доступ, неудивительно, что он становится полем активизма. Пересмотр и переинтерпретация архивов — давняя практика: группы, о которых собирались данные, могут добиваться доступа к этим материалам и права участвовать в том, как они описаны.
Описанную выше практику многие исследователи связывают с понятием цифровой репатриации, которое связано с более общим движением деколонизации музеев и музейных коллекций. Обычная, нецифровая, музейная репатриация предполагает возвращение культурных артефактов в те месте или тем народам, откуда они были взяты, например, при раскопках. Цифровая же репатриация связана с данными — цифровыми коллекциями. Её идея в том, чтобы предоставлять сообществам-источникам (группам людей, которые связаны исторически и культурно с тем наследием, которое представлено в коллекции) доступ и возможности для владения данными, интерпретации, передачи доступа и т. д. Проекты по цифровой репатриации предполагают совместную деятельность музейных работников и членов сообществ-источников. Пример: проект Ara Irititj, инициированный сообществом аборигенов А́нангу. Команда проекта отслеживает материалы, относящиеся к их культуре, в архивах Австралии, запрашивает цифровую копию объекта, составляет собственную базу данных с возможностью атрибуцировать их согласно собственной традиции, и хранит их на своём сервере.
Есть и другой вариант — проекты, которые вовлекают непрофессионалов в создание общей памяти. Классический пример — проект транскрибации рукописей Иеремии Бентама Transcribe Bentham, где волонтёры со всего мира расшифровывали рукописный архив философа.
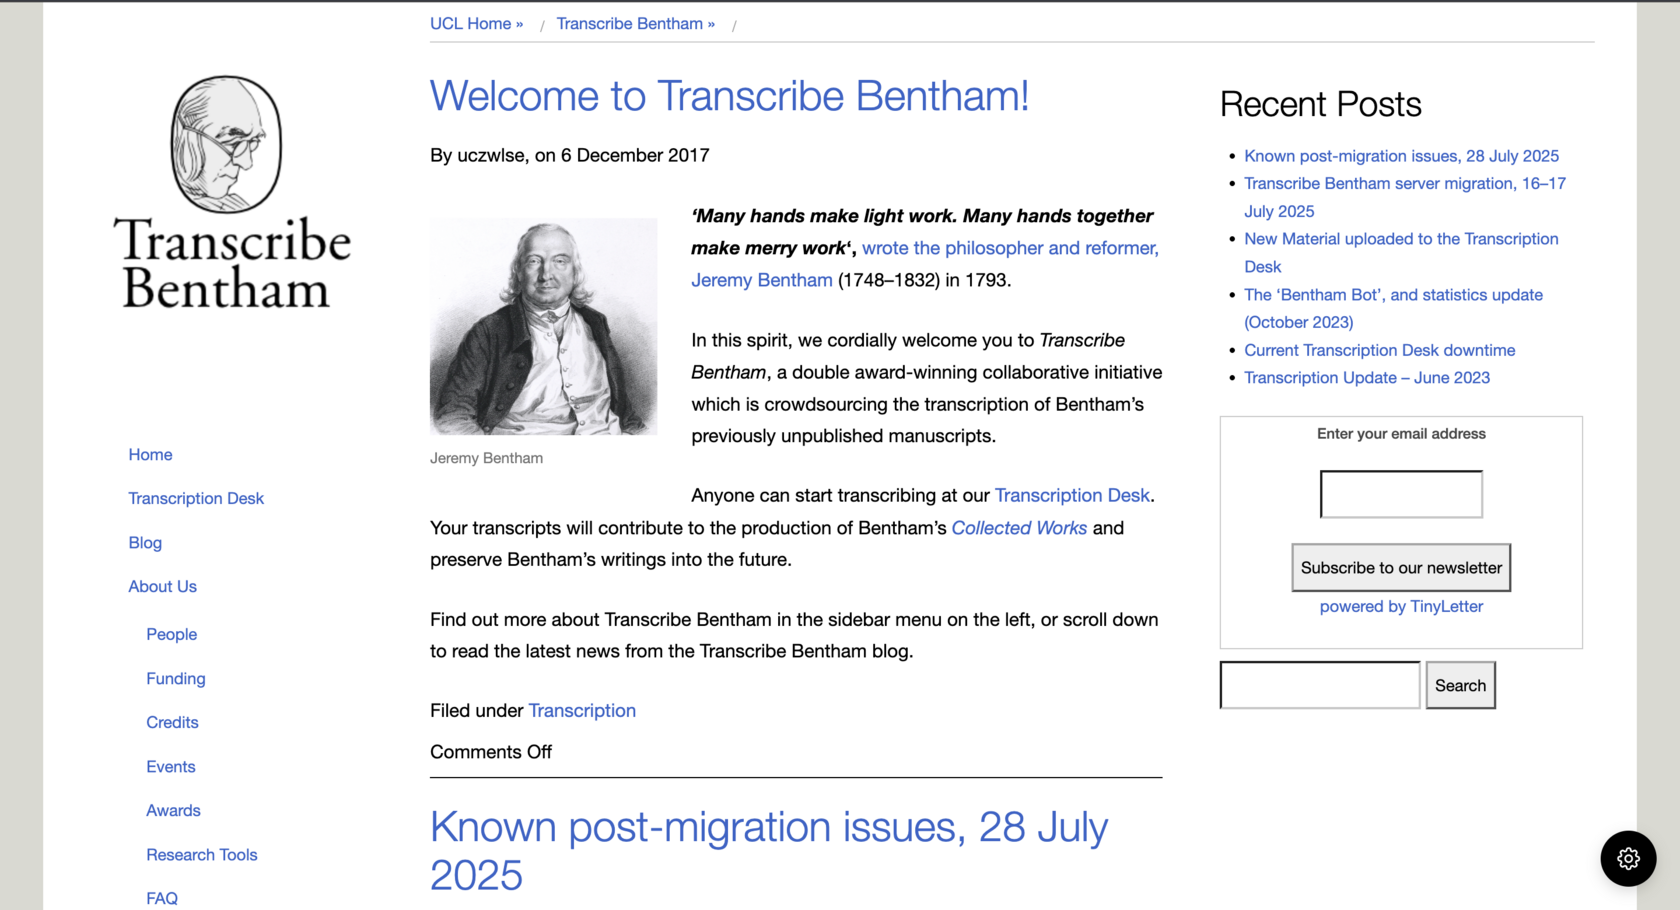
Изображение: blogs.ucl.ac.uk/transcribe-bentham
Похожую логику можно увидеть в проектах, основанных на материалах, которые люди приносят сами, например в «Прожито», о котором мы уже вспоминали, где собираются личные дневники, или в «Пишу тебе», где собираются письма и открытки. В таких случаях архив перестаёт быть чем-то, что создают эксперты «сверху», и становится совместным и распределённым усилием множества людей.
Как вы думаете, что важнее: добиваться изменения правил игры в уже существующих институциях или формировать свои, новые? Мы в этом разделе больше всего обращаемся к архивам, но можно порассуждать и о библиотеках (обращая внимание на самоорганизованные библиотеки, пиратские движения в интернете или буккроссинги в многоквартирных домах). Стоит посмотреть и на музеи и выставки: начиная от тех, что делают, например, школьники, или коллекционеры. Роль сообществ важна в любых институциях и может оставаться спорной.
/ архивная лихорадка и цифровое «сохраняем всё»
У архивной деятельности есть свой парадокс: между тем, сколько материалов мы накопили, и тем, сколько из них действительно описано, разобрано и доступно для использования, возникает разрыв. Чем больше мы собираем, тем труднее становится всё это обработать.
Здесь интересен Жак Деррида и его Archive Fever: A Freudian Impression (1995/1996) — текст о памяти, технологии и власти. Деррида связывает архив не просто с сохранением прошлого, но с желанием контролировать происхождение, память и доступ к ней. Архивная лихорадка парадоксальна: она возникает из страха перед забвением, но сама необходимость постоянно архивировать и систематизировать меняет то, что мы пытаемся сохранить.
Цифровая эпоха доводит эту логику до предела. Сохранять можно почти бесконечно, а хранение отдельного файла кажется почти бесплатным. Google Photos и Apple Memories, о которых пишут Маркхэм и Перейра, обещают самостоятельно разобраться в этом бесконечном потоке данных и выделить из него «самое значимое».
Читателями коллекций становятся не только люди. Сообщество, связанное с сохранением и изучением культурного наследия, всё активнее пытается осмыслить изменения, которые происходят с цифровыми коллекциями из-за распространения машинного обучения и систем искусственного интеллекта. В частности, Europeana и UNESCO уже рассматривают искусственный интеллект как важную часть будущего работы с культурным наследием.
Интересен в этом отношении доклад Europeana Publishing Cultural Heritage Data in the Age of AI. Его авторы предлагают различать несколько способов, которыми ИИ может взаимодействовать с коллекциями. С одной стороны, искусственный интеллект может использовать уже опубликованные коллекции как исследовательский материал: анализировать изображения и тексты, находить связи между объектами, классифицировать их или использовать данные для обучения новых моделей. С другой стороны, ИИ-системы могут обращаться непосредственно к сайтам и цифровым инфраструктурам культурных институций: автоматически считывать страницы, извлекать с них информацию или обращаться к API. В этом случае система не обязательно «учится» на коллекции. Она может использовать её как источник информации уже после обучения — примерно так же, как человек обращается к каталогу, только в гораздо большем масштабе и с гораздо большей скоростью. Europeana поэтому отдельно рассматривает различие между использованием данных для обучения моделей и использованием культурных данных уже работающими ИИ-системами.
Именно здесь возникает проблема открытого доступа. Для культурных институций открытость данных долгое время была важной частью их публичной миссии. Но появление ИИ меняет масштаб возможного использования, а массовость этого процесса усиливает асимметрию между разными его агентами: публичные учреждения несут расходы на оцифровку, хранение, каталогизацию и поддержание инфраструктуры, тогда как крупные коммерческие компании могут извлекать из этих данных значительную ценность
Если человек открывает страницу музея и смотрит один объект, это один тип доступа. Если кто-то автоматически собирает данные о миллионах объектов для обучения модели, это уже совершенно другой тип использования — даже если технически и в том и в другом случае данные являются «открытыми». Europeana прямо описывает это как переход от human-scale access к спросу на доступ к коллекциям в гораздо большем, индустриальном масштабе и разграничение режимов доступа для разного вида пользователей.
Эта проблема касается не только культурных институций, но и людей, которые трудятся в креативных индустриях: писателей, художников, музыкантов, фотографов, журналистов, издателей. Для них использование произведений ИИ напрямую связано с авторским правом: какие произведения могут использоваться для обучения моделей, требуется ли согласие автора и должно ли такое использование оплачиваться.
Здесь интересен Жак Деррида и его Archive Fever: A Freudian Impression (1995/1996) — текст о памяти, технологии и власти. Деррида связывает архив не просто с сохранением прошлого, но с желанием контролировать происхождение, память и доступ к ней. Архивная лихорадка парадоксальна: она возникает из страха перед забвением, но сама необходимость постоянно архивировать и систематизировать меняет то, что мы пытаемся сохранить.
Цифровая эпоха доводит эту логику до предела. Сохранять можно почти бесконечно, а хранение отдельного файла кажется почти бесплатным. Google Photos и Apple Memories, о которых пишут Маркхэм и Перейра, обещают самостоятельно разобраться в этом бесконечном потоке данных и выделить из него «самое значимое».
Читателями коллекций становятся не только люди. Сообщество, связанное с сохранением и изучением культурного наследия, всё активнее пытается осмыслить изменения, которые происходят с цифровыми коллекциями из-за распространения машинного обучения и систем искусственного интеллекта. В частности, Europeana и UNESCO уже рассматривают искусственный интеллект как важную часть будущего работы с культурным наследием.
Интересен в этом отношении доклад Europeana Publishing Cultural Heritage Data in the Age of AI. Его авторы предлагают различать несколько способов, которыми ИИ может взаимодействовать с коллекциями. С одной стороны, искусственный интеллект может использовать уже опубликованные коллекции как исследовательский материал: анализировать изображения и тексты, находить связи между объектами, классифицировать их или использовать данные для обучения новых моделей. С другой стороны, ИИ-системы могут обращаться непосредственно к сайтам и цифровым инфраструктурам культурных институций: автоматически считывать страницы, извлекать с них информацию или обращаться к API. В этом случае система не обязательно «учится» на коллекции. Она может использовать её как источник информации уже после обучения — примерно так же, как человек обращается к каталогу, только в гораздо большем масштабе и с гораздо большей скоростью. Europeana поэтому отдельно рассматривает различие между использованием данных для обучения моделей и использованием культурных данных уже работающими ИИ-системами.
Именно здесь возникает проблема открытого доступа. Для культурных институций открытость данных долгое время была важной частью их публичной миссии. Но появление ИИ меняет масштаб возможного использования, а массовость этого процесса усиливает асимметрию между разными его агентами: публичные учреждения несут расходы на оцифровку, хранение, каталогизацию и поддержание инфраструктуры, тогда как крупные коммерческие компании могут извлекать из этих данных значительную ценность
Если человек открывает страницу музея и смотрит один объект, это один тип доступа. Если кто-то автоматически собирает данные о миллионах объектов для обучения модели, это уже совершенно другой тип использования — даже если технически и в том и в другом случае данные являются «открытыми». Europeana прямо описывает это как переход от human-scale access к спросу на доступ к коллекциям в гораздо большем, индустриальном масштабе и разграничение режимов доступа для разного вида пользователей.
Эта проблема касается не только культурных институций, но и людей, которые трудятся в креативных индустриях: писателей, художников, музыкантов, фотографов, журналистов, издателей. Для них использование произведений ИИ напрямую связано с авторским правом: какие произведения могут использоваться для обучения моделей, требуется ли согласие автора и должно ли такое использование оплачиваться.
/ инфраструктура для будущего
В конечном счёте всё, о чём мы говорили, сходится к одному вопросу: мы сохраняем не только для настоящего, но и для будущего.
Борис Гройс в работе «О новом. Опыт экономики культуры» проблематизирует эту новизну. Он пишет, что возможность думать о новом, об инновации возникает только тогда, когда существует техническая возможность что-то сохранять (Гройс, 2000). Иными словами, само понятие «нового» становится осмысленным на фоне архива — того, относительно чего новое можно распознать как новое.
Дастон показывает это свойство связи архива и новизны на материале науки XIX века. Архивные проекты того времени были осознанно рассчитаны на будущее: учёные собирали материалы не только для себя, но и для исследователей, которые придут через десятилетия и века. Архив создавался как инфраструктура для ещё не существующих сообществ — будущих читателей и исследователей.
Сегодня ситуация меняется. Data-driven (основанные на данных) исследования строятся так, что накопленный массив данных начинает определять, какие вопросы вообще можно поставить, какие связи увидеть и какие ответы получить.
Но мы как пользователи и исследователи можем отнестись и к этим массивам данных как к чему-то, что не возникает само по себе, а может быть изучено и понято. Для этого мы обращаемся к изучению процедур.
Борис Гройс в работе «О новом. Опыт экономики культуры» проблематизирует эту новизну. Он пишет, что возможность думать о новом, об инновации возникает только тогда, когда существует техническая возможность что-то сохранять (Гройс, 2000). Иными словами, само понятие «нового» становится осмысленным на фоне архива — того, относительно чего новое можно распознать как новое.
Дастон показывает это свойство связи архива и новизны на материале науки XIX века. Архивные проекты того времени были осознанно рассчитаны на будущее: учёные собирали материалы не только для себя, но и для исследователей, которые придут через десятилетия и века. Архив создавался как инфраструктура для ещё не существующих сообществ — будущих читателей и исследователей.
Сегодня ситуация меняется. Data-driven (основанные на данных) исследования строятся так, что накопленный массив данных начинает определять, какие вопросы вообще можно поставить, какие связи увидеть и какие ответы получить.
Но мы как пользователи и исследователи можем отнестись и к этим массивам данных как к чему-то, что не возникает само по себе, а может быть изучено и понято. Для этого мы обращаемся к изучению процедур.
/ источники
Borgman, C. L., Scharnhorst, A., & Golshan, M. S. (2019). Digital data archives as knowledge infrastructures: Mediating data sharing and reuse. Journal of the Association for Information Science and Technology, 70(8), 888−904.
Daston, L. (2012). The sciences of the archive. Osiris, 27(1), 156−187.
Daston, L. (2017). The immortal archive: Nineteenth-century science imagines the future. In A. Blair, P. Duguid, A.-S. Goeing, & A. Grafton (Eds.), Information: A historical companion (pp. 629−632). Princeton University Press.
Derrida, J. (1996). Archive fever: A Freudian impression (E. Prenowitz, Trans.). University of Chicago Press. (Original work published 1995).
Гройс, Б. (2000). О новом. Опыт экономики культуры. Ad Marginem.
Larkin, B. (2013). The politics and poetics of infrastructure. Annual Review of Anthropology, 42, 327−343.
Markham, A. N., & Pereira, G. (2019). Experimenting with algorithms and memory-making: Lived experience and future-oriented ethics in critical data science. Frontiers in Big Data, 2, Article 35. https://doi.org/10.3389/fdata.2019.35
Star, S. L. (1999). The ethnography of infrastructure. American Behavioral Scientist, 43(3), 377−391.
Belteki, D., Rees, A. J., & Sichani, A.-M. (2025). Datafication and cultural heritage collections data infrastructures: Critical perspectives on documentation, cataloguing and data-sharing in cultural heritage institutions. Journal of Open Humanities Data. https://doi.org/10.5334/johd.277
Daston, L. (2012). The sciences of the archive. Osiris, 27(1), 156−187.
Daston, L. (2017). The immortal archive: Nineteenth-century science imagines the future. In A. Blair, P. Duguid, A.-S. Goeing, & A. Grafton (Eds.), Information: A historical companion (pp. 629−632). Princeton University Press.
Derrida, J. (1996). Archive fever: A Freudian impression (E. Prenowitz, Trans.). University of Chicago Press. (Original work published 1995).
Гройс, Б. (2000). О новом. Опыт экономики культуры. Ad Marginem.
Larkin, B. (2013). The politics and poetics of infrastructure. Annual Review of Anthropology, 42, 327−343.
Markham, A. N., & Pereira, G. (2019). Experimenting with algorithms and memory-making: Lived experience and future-oriented ethics in critical data science. Frontiers in Big Data, 2, Article 35. https://doi.org/10.3389/fdata.2019.35
Star, S. L. (1999). The ethnography of infrastructure. American Behavioral Scientist, 43(3), 377−391.
Belteki, D., Rees, A. J., & Sichani, A.-M. (2025). Datafication and cultural heritage collections data infrastructures: Critical perspectives on documentation, cataloguing and data-sharing in cultural heritage institutions. Journal of Open Humanities Data. https://doi.org/10.5334/johd.277