1. что такое датафикация, и почему к ней нужно относиться с осторожностью
содержание:
Слово «данные» относится к самым разным контекстам, но означает в них нечто похожее — это то, что дано, известно о каком-то явлении и структурировано в соответствии со способом обращения.
Данные о книгах, самочувствии, городском транспорте, продажах или политических настроениях россиян собираются по-разному. Но их объединяет парадокс:
а) максимальное соответствие объекту (данные — как бы сами сообщают о явлении),
б) данные — не даны, а собраны, извлечены, систематизированы, представлены.
Как это сочетается? Парадокс решают исследователи науки и техники, философии и социологии знания. Мы доверяем данным, так как верим в объективность и экспертизу.
Данные важны не только потому, что они парадоксальны. Мы постоянно вовлечены в принятие решений, основанных на данных. Где поставить книгу, как проводить занятия, какую иллюстрацию ставить к публикации, как планировать бюджет, что надевать на прогулку — это решения, которые могут быть основаны на ощущении, решительном плане, но также нередко — на данных. Данные считаются надёжными и близкими к тому, что мы называем реальностью. И они сами становятся частью понятного мира.
а) максимальное соответствие объекту (данные — как бы сами сообщают о явлении),
б) данные — не даны, а собраны, извлечены, систематизированы, представлены.
Как это сочетается? Парадокс решают исследователи науки и техники, философии и социологии знания. Мы доверяем данным, так как верим в объективность и экспертизу.
Данные важны не только потому, что они парадоксальны. Мы постоянно вовлечены в принятие решений, основанных на данных. Где поставить книгу, как проводить занятия, какую иллюстрацию ставить к публикации, как планировать бюджет, что надевать на прогулку — это решения, которые могут быть основаны на ощущении, решительном плане, но также нередко — на данных. Данные считаются надёжными и близкими к тому, что мы называем реальностью. И они сами становятся частью понятного мира.
/ из чего состоят данные
Начнём мы не с того, откуда они берутся вообще, а с момента столкновения с данными. Это жизненная или рабочая ситуация, любая из описанных выше. Например, принятие решения о том, что надеть: собираясь на улицу, мы смотрим в телефоне, сколько градусов и идёт ли дождь (и опираемся на данные).
Мы можем высунуть нос на улицу, и тогда у нас будет ощущение.
Но нередко при сравнении мы поверим цифрам. Ведь у данных высокий эпистемический авторитет — мы доверяем им (иногда больше, чем ощущениям или другим источникам знания и переживания о мире).
Обращаясь к данным, мы имеем дело с их визуализацией или репрезентацией. Например, в случае погоды это облака или солнце на экране, а также количество градусов. Прогноз погоды на телевидении снабжается иногда ещё и красочным фильмом о передвижениях циклона.
Но за иллюстрациями стоит другая визуальная форма представления данных. Она часто является чем-то вроде исходного материала и находится «за» оформленной картинкой/графиком. Обычно это табличка, в которой собраны материалы о наблюдениях, скажем, за погодой. Табличка — тоже форма представления данных. Такие же записи можно делать в блокноте или вордовском файле. Но табличка позволяет совершать с данными операции, с помощью которых можно выявлять закономерности, легко подсчитывать и даже прогнозировать.
Мы можем высунуть нос на улицу, и тогда у нас будет ощущение.
Но нередко при сравнении мы поверим цифрам. Ведь у данных высокий эпистемический авторитет — мы доверяем им (иногда больше, чем ощущениям или другим источникам знания и переживания о мире).
Обращаясь к данным, мы имеем дело с их визуализацией или репрезентацией. Например, в случае погоды это облака или солнце на экране, а также количество градусов. Прогноз погоды на телевидении снабжается иногда ещё и красочным фильмом о передвижениях циклона.
Но за иллюстрациями стоит другая визуальная форма представления данных. Она часто является чем-то вроде исходного материала и находится «за» оформленной картинкой/графиком. Обычно это табличка, в которой собраны материалы о наблюдениях, скажем, за погодой. Табличка — тоже форма представления данных. Такие же записи можно делать в блокноте или вордовском файле. Но табличка позволяет совершать с данными операции, с помощью которых можно выявлять закономерности, легко подсчитывать и даже прогнозировать.
Джоанна Дракер посвятила изучению данных много исследований. Она показала, что в гуманитарных работах есть альтернативные способы работать с данными: и графически, и на уровне понятий. Мы ещё вернёмся к её разработкам, например, понятию «взятых» или сравнению форм визуализации (Подробнее: Drucker, 2011)
Чтобы поместить данные в табличку, нужно сначала продумать механизм сбора и анализа данных: понять, что именно мы будем узнавать, потом осуществить эту операцию, а потом — обработать то, что собрано. Иногда это продумывание сделано задолго до того, как мы вообще стали размышлять о структурах: например, метеорологические сводки собираются столетиями, но форма их сбора периодически обновляется в разных организациях.
Часто о собранном, но несортированном говорят, что это «сырые данные». На деле они никогда не «сырые», так как им предшествует: а) выделение области мира, которую мы будем изучать, и б) вопросы, которые позволят классифицировать это изучение, чтобы потом в) представлять данные в соответствии с тем, как принято это делать. Получается, на входе нам уже нужно вообразить желаемый результат — что с собранным будет происходить. (Подробнее: Gitelman, 2013)
Часто о собранном, но несортированном говорят, что это «сырые данные». На деле они никогда не «сырые», так как им предшествует: а) выделение области мира, которую мы будем изучать, и б) вопросы, которые позволят классифицировать это изучение, чтобы потом в) представлять данные в соответствии с тем, как принято это делать. Получается, на входе нам уже нужно вообразить желаемый результат — что с собранным будет происходить. (Подробнее: Gitelman, 2013)
Книга Лизы Гительман так и называется: «Сырые данные — это оксюморон». Кстати, эта книга хороша тем, что в ней рассматриваются разные периоды из истории данных: есть глава и про астрономию, и про цифровые данные. И в каждом случае сбор данных и работа с ними, да и само это понятие, культурно и исторически обусловлены, а не универсальны.
Ещё в данные всегда включены инструменты, с помощью которых их собирают. Например, данные о температуре можно собирать не только с помощью термометров в разных частях города. Даже если физически вы не находитесь в конкретном месте, вы можете соотнести другие данные, использовать определённые показатели — и (таким образом) рассчитать температуру с огромной точностью. То есть мы можем больше доверять механизмам, людям, математическим формулам и так далее. Заметьте, слово «доверие» возникает уже не в первый раз! И это неспроста: мы доверяем инструментам, предполагая доверие самим данным.
В этом материале Хабра авторы рассказывают, из каких источников собираются данные для предсказания погоды в сервисе Яндекс Погода, и как некоторых источников и инструментов бывает недостаточно, и приходится спрашивать в том числе пользователей о состоянии природы за окном.
И вот интересный пример сообщества метеорологов-энтузиастов, которые работают и экспериментируют с разными данными.
Интересно, что такой подход не всегда уменьшает авторитета данных в целом. Но почему, несмотря на скептические замечания о данных в медиа или науке, наше доверие к цифрам всё же велико, и числовые показатели продолжают влиять на нашу жизнь? При каких обстоятельствах мы перестаём полагаться на цифры?
/ данные в исследованиях и индустриях. большие данные
Скорее всего, если бы тема данных ограничивалась историей науки и информацией, она не вызывала бы столько внимания. Слово «данные» обладает всё более притягательной силой, а уж тем более если мы говорим о «больших данных». Уже стало банальностью сравнение данных с нефтью или другими ресурсами.
Решения, принятые на основе данных, считаются более эффективными, так как данные будто бы фиксируют и описывают то, что происходит на самом деле, и даже без сформулированного запроса рассказывают о мире. Использование данных в автоматизации — это большая часть работы по внедрению ИИ и интеллектуальных систем.
Такой подход не нов. Он основан на идее о том, что информация — это основа и экономики, и политики, а отчасти и жизни в целом. Но информация ценна не сама по себе. Знание о мире — будь то статистические сводки о населении, материалы продаж или страничка социальной сети — ценно потому что должно влиять на решения.
Предки современной веры в данные — это кибернетика и идея информационного общества. Сообразно им, управление возможно на основе объективной информации о процессах, обществе, труде. Эта информация должна быть выражена в данных, а работа с ней устроена по правилам, из которых формируются алгоритмы.
Конечно, не только информация влияет на принятие решений. Нами могут руководить вера или страсть, традиция, любопытство или политические события. Чтобы признавать информацию такой уж важной, нужно считать, что люди, занятые управлением — рациональны, и делая выбор, нам учитывают то, что мы известно о мире. То есть речь идёт не только о способе производства, но и о специфическом субъекте.
Важно уметь жить в мире с данными и понимать, как они возникли и чем могут пригодиться. Такая субъектность формируется на уровне образования: нас учат понимать мир некоторым образом, а потом мы сами учимся дополнять этот образ. Это и есть специализация, хотя база закладывается ещё в школе. Представьте человека из другой эпохи: он бы просто не понял, как обращаться с нашими системами знания о мире.
Системы знания и работы с данными исторически изменчивы. Например, если нам известно, что в мире востребованы определённые профессии, мы будем учитывать это при поступлении в университет. Если в гороскопе написано, что с определённым знаком зодиака нашему знаку будет тяжело и муторно, люди склонны объяснять этим неуспешные отношения. Знание о статистике потребления воды может влиять на выключение крана во время чистки зубов.
Но тема «больших данных» вывела ситуацию на новый уровень. Под термином «большие данные» обычно понимают данные в больших объёмах (терабайты и петабайты памяти), собираются непрерывно (как, например, данные о действиях пользователей в социальных сетях) и представлены в разных форматах. В 2008 году шуму наделала статья о том, что поворот к большим данным означает «конец теории» (Anderson, 2008).
Решения, принятые на основе данных, считаются более эффективными, так как данные будто бы фиксируют и описывают то, что происходит на самом деле, и даже без сформулированного запроса рассказывают о мире. Использование данных в автоматизации — это большая часть работы по внедрению ИИ и интеллектуальных систем.
Такой подход не нов. Он основан на идее о том, что информация — это основа и экономики, и политики, а отчасти и жизни в целом. Но информация ценна не сама по себе. Знание о мире — будь то статистические сводки о населении, материалы продаж или страничка социальной сети — ценно потому что должно влиять на решения.
Предки современной веры в данные — это кибернетика и идея информационного общества. Сообразно им, управление возможно на основе объективной информации о процессах, обществе, труде. Эта информация должна быть выражена в данных, а работа с ней устроена по правилам, из которых формируются алгоритмы.
Конечно, не только информация влияет на принятие решений. Нами могут руководить вера или страсть, традиция, любопытство или политические события. Чтобы признавать информацию такой уж важной, нужно считать, что люди, занятые управлением — рациональны, и делая выбор, нам учитывают то, что мы известно о мире. То есть речь идёт не только о способе производства, но и о специфическом субъекте.
Важно уметь жить в мире с данными и понимать, как они возникли и чем могут пригодиться. Такая субъектность формируется на уровне образования: нас учат понимать мир некоторым образом, а потом мы сами учимся дополнять этот образ. Это и есть специализация, хотя база закладывается ещё в школе. Представьте человека из другой эпохи: он бы просто не понял, как обращаться с нашими системами знания о мире.
Системы знания и работы с данными исторически изменчивы. Например, если нам известно, что в мире востребованы определённые профессии, мы будем учитывать это при поступлении в университет. Если в гороскопе написано, что с определённым знаком зодиака нашему знаку будет тяжело и муторно, люди склонны объяснять этим неуспешные отношения. Знание о статистике потребления воды может влиять на выключение крана во время чистки зубов.
Но тема «больших данных» вывела ситуацию на новый уровень. Под термином «большие данные» обычно понимают данные в больших объёмах (терабайты и петабайты памяти), собираются непрерывно (как, например, данные о действиях пользователей в социальных сетях) и представлены в разных форматах. В 2008 году шуму наделала статья о том, что поворот к большим данным означает «конец теории» (Anderson, 2008).
…Теперь есть лучший способ [расширения научного знания]. Петабайты данных позволяют нам сказать: «Корреляции достаточно». Мы можем перестать искать [теоретические] модели. Мы можем анализировать данные без гипотез о том, что они могут показать. Мы можем загрузить эти данные в самые большие вычислительные кластеры, которые когда-либо видел мир, и позволить статистическим алгоритмам находить закономерности там, где наука не может. (…)
Освоение «компьютера» такого масштаба может быть сложной задачей. Но возможности огромны: новая доступность огромных объемов данных, наряду со статистическими инструментами для обработки этих данных, предлагает совершенно новый способ понимания мира. Корреляция превосходит причинно-следственную связь, и наука может развиваться даже без согласованных моделей, единых теорий или вообще каких-либо механистических объяснений.
В приведённой цитате автор говорит нам, что постоянно повышающегося объёма данных достаточно для того, чтобы делать научные открытия без теоретических моделей и гипотез, достаточно компьютеров, которые будут устанавливать связи и делать предсказания. Энтузиазм по поводу больших данных с того времени поутих (вот, например, об этом статья на Хабре), но сама идея о том, что данных может быть достаточно, чтобы объяснить нам мир, всё ещё жива.
/ данные и политика. структура и родственники данных
Но теперь перейдём к концептам, которые связаны с понятием данных.
Связь между:
1) машинами,
2) измерениями общества
3) изучением людей и явлений
4) анализом этого всего в рамках организаций и разных наук — старое явление.
Обследования населения и имущества затевались ещё в древнем мире, например, они были нужны при сборе налогов, чтобы рассчитывать сумму налога с каждого человека или дела, а также понимать устройство бюджета государства. Неудивительно, что они наследуют с тех времён и возможности, и свойства этого процесса: те, кто собирает данные, оказываются сильнее, а те, кто их отдаёт — оказываются подсчитанными, объективированными, узнанными. И, конечно, многие поэтому и не любят сборщиков данных.
Уже на этом старинном примере видно, что данные связаны с властью. Эта связь не всегда такая линейная, как при разговоре о сборе налогов. Ведь чтобы собирать данные, нужно уже обладать некоторой властью. А те, кто научается увеличивать свои возможности с помощью данных, обременяются большей властью. Эта власть не всегда находится не в руках людей. Иногда она в процедурах, методах, инструментах: тех самых табличках, опросных листах или графиках.
Разберёмся в этом на примере со статистикой. Ведь данных наследует многим статистическим процедурам: механическим или структурным. Механические, проще говоря, связан с инструментами фиксации, а структурные — с тем, как мы создаём классификации. Важно — это исторически разные формы представления знания и его конструирования. Они не всегда идентичны тому, что существует сегодня, а ещё в работе со статистикой очень много ситуативных решений.
Связь между:
1) машинами,
2) измерениями общества
3) изучением людей и явлений
4) анализом этого всего в рамках организаций и разных наук — старое явление.
Обследования населения и имущества затевались ещё в древнем мире, например, они были нужны при сборе налогов, чтобы рассчитывать сумму налога с каждого человека или дела, а также понимать устройство бюджета государства. Неудивительно, что они наследуют с тех времён и возможности, и свойства этого процесса: те, кто собирает данные, оказываются сильнее, а те, кто их отдаёт — оказываются подсчитанными, объективированными, узнанными. И, конечно, многие поэтому и не любят сборщиков данных.
Уже на этом старинном примере видно, что данные связаны с властью. Эта связь не всегда такая линейная, как при разговоре о сборе налогов. Ведь чтобы собирать данные, нужно уже обладать некоторой властью. А те, кто научается увеличивать свои возможности с помощью данных, обременяются большей властью. Эта власть не всегда находится не в руках людей. Иногда она в процедурах, методах, инструментах: тех самых табличках, опросных листах или графиках.
Разберёмся в этом на примере со статистикой. Ведь данных наследует многим статистическим процедурам: механическим или структурным. Механические, проще говоря, связан с инструментами фиксации, а структурные — с тем, как мы создаём классификации. Важно — это исторически разные формы представления знания и его конструирования. Они не всегда идентичны тому, что существует сегодня, а ещё в работе со статистикой очень много ситуативных решений.
Например, если мы анализируем цвета в романе Льва Толстого, то нам нужно задать механические инструменты «выхватывания» названий цветов и определить структуру базы данных: что в неё попадёт, как будут сгруппированы цвета, будем ли мы считать багровый — красным, а слово «алеющий» — указанием на цвет.
В статистике метод сбора — это отдельный большой вопрос, и на конференциях и в журналах по статистике ведутся свои дискуссии о том, где и какой способ получения информации и измерения лучше. Часто добродетелью в статистических измерениях становится объективность, минимизация участия самого исследователя. (Подробнее: Галисон & Дастон, 2018.) Или наоборот — максимизация участия для того, чтобы данные стали «чистыми». Если мы говорим о процедурах «очистки», то они включают в себя и техники, и конкретные материальные, технологические решения. Связь с технологиями у статистических методов, в том числе из-за этого, очень долгая, она длится не одно столетие.
Про историю связи статистики и машин можно почитать подробнее в книгах Reckoning with matter: Calculating machines, innovation, and thinking about thinking from Pascal to Babbage (Jones, 2016) и Metric Power (Beer, 2018)
Не меньше и связь статистики с опасениями по поводу наблюдений и слежки. Нередко критики статистических подходов обращаются к примерам из начала ХХ века, когда во многих странах происходили переписи населения и его свойств: социальных, демографических, тех, что касаются частной жизни. Яркий пример этого — история с картотекой Бюро статистики в Нидерландах в первой половине XX века. К 1939 году каждый гражданин должен был иметь документ, куда в том числе включалась графа «происхождение». После вторжения немцев в 1940 году эти данные были использованы для преследования еврейского населения и массовой депортации в концентрационные лагеря. Эта история показывает нам, как при меняющихся политических условиях само наличие данных может ставить социальные группы в уязвимую позицию (Hilberg, 2003).
Эти исторические экскурсы важны, чтобы видеть в том, что мы сегодня называем «данными», не нечто, появившееся только в эпоху интернета и цифровых следов, а часть большой истории. В статистических измерениях есть преемственность. Так, англо-саксонская система статистики тесно связана со сбором показателей, нужным для того, чтобы оценивать работу институций (например, школ). В других странах такой традиции не было, и показатели в статистических бюро — другие.
Эти исторические экскурсы важны, чтобы видеть в том, что мы сегодня называем «данными», не нечто, появившееся только в эпоху интернета и цифровых следов, а часть большой истории. В статистических измерениях есть преемственность. Так, англо-саксонская система статистики тесно связана со сбором показателей, нужным для того, чтобы оценивать работу институций (например, школ). В других странах такой традиции не было, и показатели в статистических бюро — другие.
Во многих музеях проводят исследования, которые показывают базовые статистические показатели: возраст, пол, город происхождения посетителей. Но не всегда понятно, что делать с этими данными, даже если они копятся десятилетиями. И важно ли то, сколько ходит женщин и мужчин в краеведческий музей? Может быть, нужно менять классификации, чтобы узнавать более полезную информацию? Этот вопрос вы можете применить к своей сфере деятельности и поразмышлять, придумывая альтернативные классификации.
Ещё много статистики собирают предприятия, чтобы улучшать работу, повышать эффективность.
В США обычно это соотносят с «тейлоризмом», по имени Фредерика Уинслоу Тейлора. Он предложил устраивать деятельность рабочих в соответствии с научными теориями, распределять задачи между рабочими, измерять эффективность труда и принимать меры на основе изучения разных процессов работы. Эти принципы с тех пор не раз оспаривались, но до сих пор находятся в основе многих управленческих процессов.
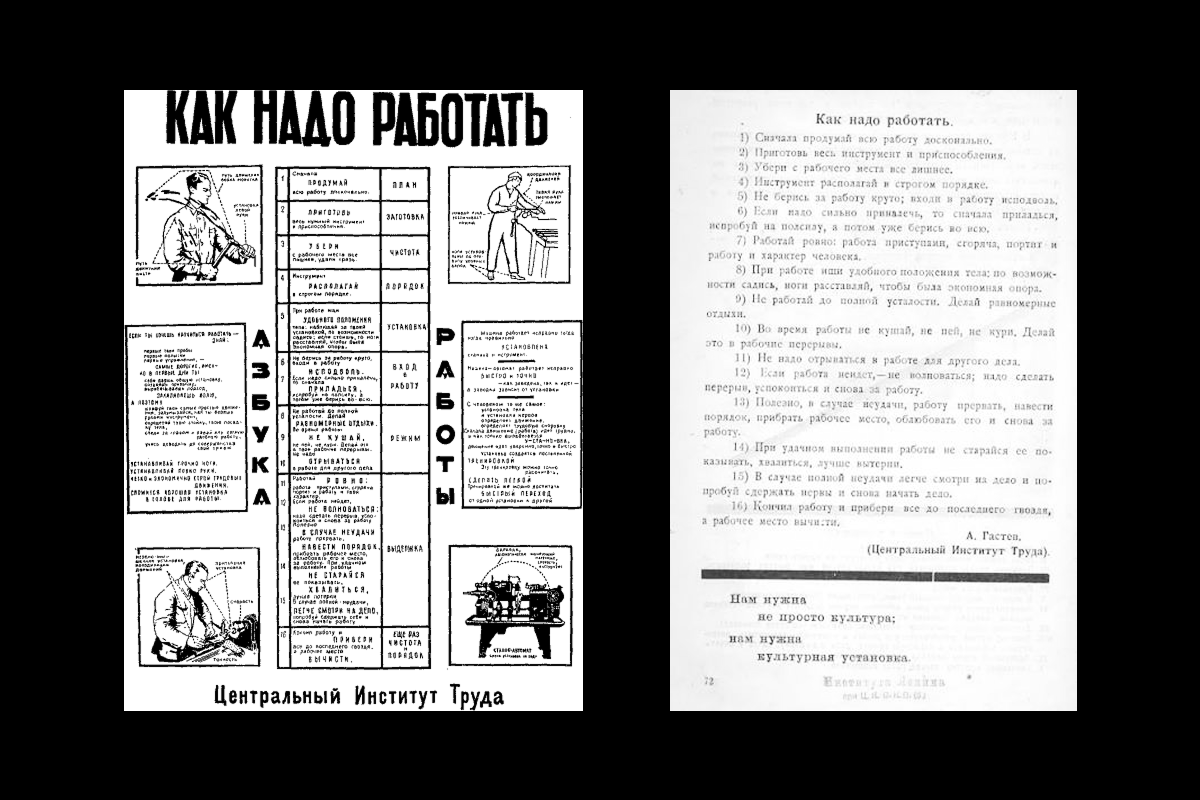
Российские и советские (позже) учёные и изобретатели спорили с тейлоризмом. Пожалуй, одна из самых известных разработок в области советского управления трудом — это работы Алексея Гастева. Гастев спорил и с Фордом, и с Тейлором, доказывая, что главное в процессе труда — это становление рабочего. Это не было похоже на современное внимание к человеку. Гастев понимал рационально, как коммунист и революционер — а значит, рациональность труда была ценной не для повышения эффективности предприятий, а для общества и человека в целом. Его книга «Как надо работать» — впечатляюще интересная, и позволяет понять, как по-разному можно понимать труд и оценку показателей (Гастев, 1972).
В США обычно это соотносят с «тейлоризмом», по имени Фредерика Уинслоу Тейлора. Он предложил устраивать деятельность рабочих в соответствии с научными теориями, распределять задачи между рабочими, измерять эффективность труда и принимать меры на основе изучения разных процессов работы. Эти принципы с тех пор не раз оспаривались, но до сих пор находятся в основе многих управленческих процессов.
Российские и советские (позже) учёные и изобретатели спорили с тейлоризмом. Пожалуй, одна из самых известных разработок в области советского управления трудом — это работы Алексея Гастева. Гастев спорил и с Фордом, и с Тейлором, доказывая, что главное в процессе труда — это становление рабочего. Это не было похоже на современное внимание к человеку. Гастев понимал рационально, как коммунист и революционер — а значит, рациональность труда была ценной не для повышения эффективности предприятий, а для общества и человека в целом. Его книга «Как надо работать» — впечатляюще интересная, и позволяет понять, как по-разному можно понимать труд и оценку показателей (Гастев, 1972).
Стоит иметь в виду, что данные — это не то же самое, что статистика. Ведь они могут быть результатами включённого наблюдения или, например, нарративами интервью или текстовыми материалами. Сбор данных связан с разработкой способов:
Вот мы и дошли до тем, которые интересны и инженерам, и гуманитарным учёным. Например, так, в 1962 году исследователи данных описывали работу с анализом данных так:
- свидетельства,
- наблюдения,
- очевидности (evidence),
- оценивания
- фиксации.
Вот мы и дошли до тем, которые интересны и инженерам, и гуманитарным учёным. Например, так, в 1962 году исследователи данных описывали работу с анализом данных так:
(1) Анализ данных должен стремиться к большему охвату и полезности, а не к безопасности.
(2) Анализ данных должен быть готов умеренно часто ошибаться, чтобы недостаточные доказательства чаще указывали на правильный ответ.
(3) Анализ данных должен использовать математические аргументы и математические результаты в качестве основания для суждения, а не в качестве основы для доказательств или подтверждения достоверности.
(Подробнее: Tukey, 1962)
В разных науках понятие очевидного отличается (у социологов оно не такое, как у психологов, а у историков — не то же, что у медиа-исследователей).
Наконец, отличается и способ внедрения и встречи, столкновения с данными. Например, сегодня мы часто говорим о связи данных и алгоритмов. Алгоритмам посвящен отдельный раздел, но здесь начала нам важно, что это способы систематизации того, что мы узнаём. Алгоритмы затем, в свою очередь, используются, чтобы механизировать в том числе принятие решений на основе данных.
Наконец, отличается и способ внедрения и встречи, столкновения с данными. Например, сегодня мы часто говорим о связи данных и алгоритмов. Алгоритмам посвящен отдельный раздел, но здесь начала нам важно, что это способы систематизации того, что мы узнаём. Алгоритмы затем, в свою очередь, используются, чтобы механизировать в том числе принятие решений на основе данных.
Например, алгоритмы музыкальных сервисов работают так: сначала они собирают данные о музыке, которую вы слушаете, а затем предлагают вам новые/ схожие композиции, которые могут вам понравиться. Это значит, что работа алгоритма — это и фиксация музыкальных треков из вашего плейлиста по разным категориям, и обработка этих данных — выявление того, что вам больше всего нравится, что вы переслушиваете, и анализ других, ещё неизвестных вам треков по разным категориям, и выдача результата в виде предложенных следующих композиций. Большая работа, которую раньше выполняли сотрудники музыкальных журналов, анализируя порой другие материалы: вышедшие альбомы, посещаемость концертов и так далее.
Что же получается? Этот проект не про данные, а про устройство общества? Как это поможет вам разобраться в проблемах данных, их достоверности, точности и этике?
Например, алгоритмы музыкальных сервисов работают так: сначала они собирают данные о музыке, которую вы слушаете, а затем предлагают вам новые/ схожие композиции, которые могут вам понравиться. Это значит, что работа алгоритма — это и фиксация музыкальных треков из вашего плейлиста по разным категориям, и обработка этих данных — выявление того, что вам больше всего нравится, что вы переслушиваете, и анализ других, ещё неизвестных вам треков по разным категориям, и выдача результата в виде предложенных следующих композиций. Большая работа, которую раньше выполняли сотрудники музыкальных журналов, анализируя порой другие материалы: вышедшие альбомы, посещаемость концертов и так далее.
/ почему данные стали «расти» и как может быть иначе
Но для самых разных методов работы с данными важно, чтобы данных было как можно больше. Причём это важно в двух смыслах. Во-первых, учёные стремились увеличивать размер выборки, чтобы модели для анализа были точными. Во-вторых, данные считались высококачественными, если их можно применять к разным ситуациям и моделям. А почему мы говорим о моделировании? Потому что особенность данных в управлении — они могут не просто описывать ситуацию, но и формировать будущее. Вот почему они нужны при принятии решений.
Обычно это описывается через термины:
Кроме того, данные должны предполагать или делать возможной «правильную» (сообразную правилам) категоризацию. Кавычки мы используем, так как на деле речь не идёт о какой-то единственной правильности. Иногда категоризация связана с удобством, иногда — с традицией. Она может быть для выбранной и более подходящей теории или скорее основана на том, что мы видим в практиках.
Обычно это описывается через термины:
- С середины ХХ века усиливается идея о необходимой предиктивности (данные должны предсказывать будущие тенденции на основе текущих и прошлых изменений и закономерностей).
- Работа с данными предполагается полезной для выявления паттернов (то есть образцов, на основе которых принимаются решения о том, что некоторое сочетание событий или показателей — закономерно).
- Ещё данные должны быть валидными — собранными так, чтобы метод соответствовал задачам, выборке и результату.
- Желательно, чтобы данные были консистентными: это значит, что они должны быть однородными внутри себя, скажем, в графе возраст был всегда возраст, а не год рождения.
- «Качественные» и «большие» данные считаются репрезентативными — то есть отражающими реальный мир.
Кроме того, данные должны предполагать или делать возможной «правильную» (сообразную правилам) категоризацию. Кавычки мы используем, так как на деле речь не идёт о какой-то единственной правильности. Иногда категоризация связана с удобством, иногда — с традицией. Она может быть для выбранной и более подходящей теории или скорее основана на том, что мы видим в практиках.
Есть немало критики репрезентативизма. Основная проблема с этим понятием в том, что оно предполагает, будто мир существует в какой-то готовой форме до того, как мы начали его рассматривать. Между тем, часто всё устроено ровно наоборот — многие показатели вовсе не существуют, пока мы не начали ими заниматься, особенно если речь идёт о социальном мире.
Например, эта проблема есть с показателями вроде «социального благополучия». Думали ли мы, что существует некое «социальное благополучие» до того, как превратили его в фиксируемый количественно показатель?
Данные почти неизбежно несут «позитивистский» флёр: что можно всё предсказать, основываясь на научном методе и подсчёте. Для того, чтобы отнестись к этому критически, конечно, стоит понимать историю такого отношения: когда, кем и зачем оно культивировалось.
Например, Метью Джонс в статье «How We Became Instrumentalists (Again): Data Positivism since World War II» показывает, что современная data science исторически сместилась от построения объясняющих моделей к созданию инструментов, которые прежде всего успешно предсказывают, даже если их внутреннюю логику невозможно интерпретировать.
(Подробнее: Jones, 2018)
Сегодня часто говорят об альтернативных трактовках данных: тех, что происходят из незападных обществ, например. Ведь понимание данных в нашем контексте связано с тем, как устроено знание — и с тем, как устроено само разделение на «реальность», «знание» и «воображение». В тех обществах, где, например, мир не является объектом осмысления, а сам предлагает свои интерпретации — данные могут быть чем-то совсем иным. Другой способ говорить и думать о данных иначе — привлекать людей, которые являются вообще-то «источниками данных», и говорить о том, как они воображают это явление. В таком случае можно увидеть совсем другое взаимодействие с властью и с тем, как по-разному устроено понимание справедливости в теме данных. (Подробнее: Milan & Treré, 2019; Ruppert, 2018)
Вот небольшой разговор о том, как базы данных о знании могут работать для австралийских аборигенов. В их структурах знания нет такой иерархической связи между данными и метаданными (то есть данными о данных, например, геолокация вашего телефонного разговора), как в условных западных обществах.
Вот небольшой разговор о том, как базы данных о знании могут работать для австралийских аборигенов. В их структурах знания нет такой иерархической связи между данными и метаданными (то есть данными о данных, например, геолокация вашего телефонного разговора), как в условных западных обществах.
При этом есть впечатляюще интересные цифровые гуманитарные проекты, которые сами коренные австралийцы вместе с обычными учёными делали, чтобы сохранить свой язык и традиции. Вот здесь можно о них почитать.
А пока можно поупражняться в воображении других миров данных, подумать о ваших собственных практиках и том, что мы называем (или нет) данными. Воображение и примеры важны для критического подхода. Во многом он с них начинается, а потом речь пойдёт об анализе, узнавании того, как устроены способы производства и использования данных.
В следующих разделах будем иметь в виду их политическую роль и этические беспокойства, которые могут возникать. И снова возвращаться к тому, что может быть интересным, удобным, забавным, психотерапевтически полезным, приятным способом работать с данными как понятием и явлением.
В следующих разделах будем иметь в виду их политическую роль и этические беспокойства, которые могут возникать. И снова возвращаться к тому, что может быть интересным, удобным, забавным, психотерапевтически полезным, приятным способом работать с данными как понятием и явлением.
/ источники
- Anderson, C. (2008). The end of theory: The data deluge makes the scientific method obsolete. Wired Magazine, 16(7).
- Beer, D. (2016). Metric power. Palgrave Macmillan.
- boyd, d., & Crawford, K. (2012). Critical questions for big data: Provocations for a cultural, technological, and scholarly phenomenon. Information, Communication & Society, 15(5), 662−679. https://doi.org/10.1080/136 9118X.2012.678 878
- Drucker, J. (2011). Humanities approaches to graphical display. Digital Humanities Quarterly, 5(1), 1−21.
- Gitelman, L. (Ed.). (2013). Raw data is an oxymoron. MIT Press.
- Hilberg, R. (2003). The destruction of the European Jews. Yale University Press.
- Jones, M. L. (2016). Reckoning with matter: Calculating machines, innovation, and thinking about thinking from Pascal to Babbage. University of Chicago Press.
- Jones, M. L. (2018). How we became instrumentalists (again): Data positivism since World War II. Historical Studies in the Natural Sciences, 48(5), 673−684. https://doi.org/10.1525/hsns.2018.48.5.673
- Milan, S., & Treré, E. (2019). Big data from the south (s): Beyond data universalism. Television & New Media, 20(4), 319−335. https://doi.org/10.1177/1 527 476 419 837 739
- Ruppert, E. (2018). Sociotechnical imaginaries of different data futures.
- Sicular, S. (2013). Gartner’s big data definition consists of three parts, not to be confused with three "V"s. Gartner.
- Tukey, John W. (1962) The Future of Data Analysis." The Annals of Mathematical Statistics 33, no. 1: 1−67. http://www.jstor.org/stable/2 237 638
- Vis, F. (2013). A critical reflection on Big Data: Considering APIs, researchers and tools as data makers. First Monday, 18(10). https://doi.org/10.5210/fm.v18i10.4878
- Галисон, П., & Дастон, Л. (2018). Объективность. Новое литературное обозрение.
- Гастев, А. К. (1972). Как надо работать. Экономика.